Table of Contents
A Nova Geração de Modelos LLM: Por Que o Raciocínio Profundo Muda Tudo
Durante os últimos quatro anos, a corrida pelo estado da arte em inteligência artificial generativa esteve ancorada quase que exclusivamente na expansão das leis de escala de pré-treinamento (pre-training scaling laws). O axioma parecia definitivo: mais parâmetros, mais petabytes de texto e clusters cada vez mais massivos de GPUs inevitavelmente produziriam inteligência superior. Contudo, a engenharia de software e a ciência da computação depararam-se com uma barreira intrínseca a essa abordagem: a natureza estocástica da predição do próximo token.
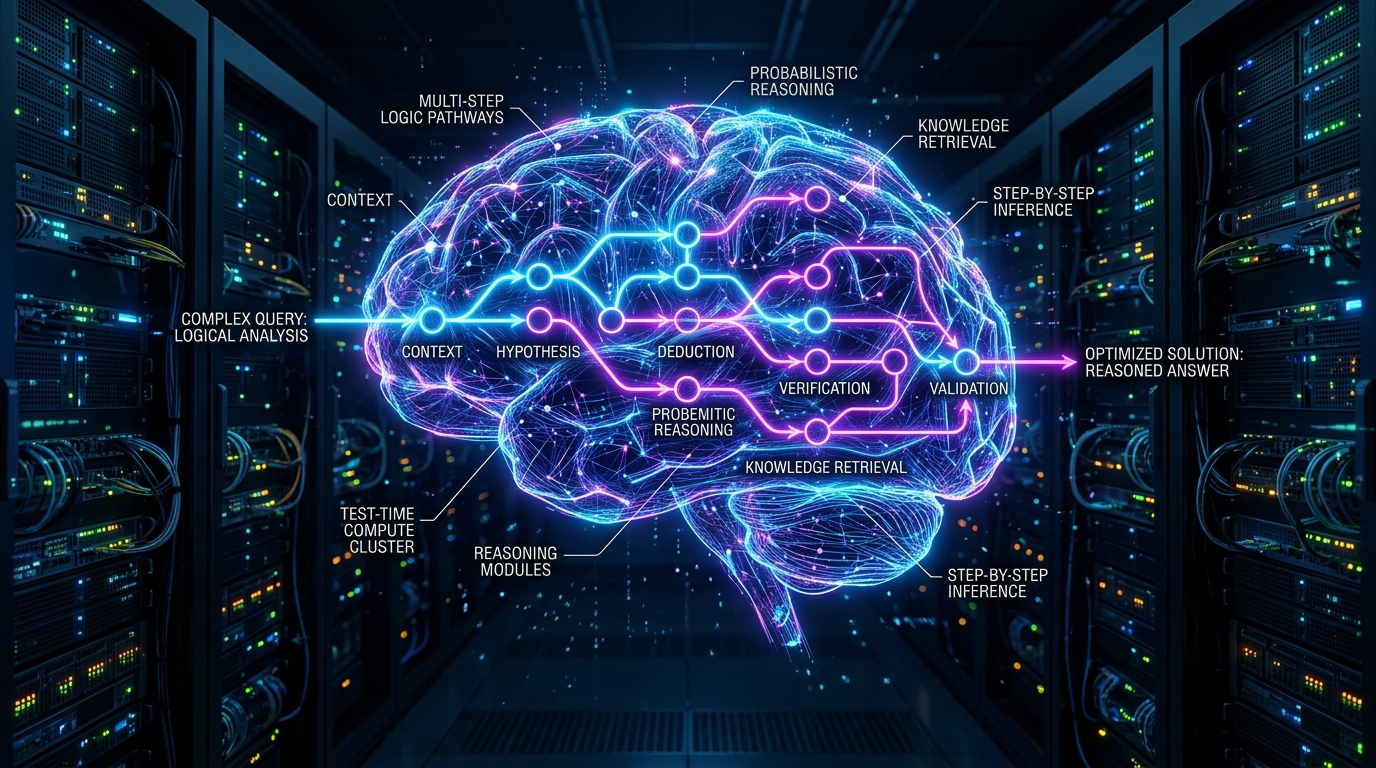
A chegada de arquiteturas voltadas para raciocínio profundo (Deep Reasoning) e computação em tempo de inferência (Test-Time Compute) — consubstanciadas em referências como OpenAI o1, o3 e as variantes Gemini Thinking (como Gemini 3.7 Thinking) — rompe essa barreira paradigmática. Em vez de disparar respostas imediatas baseadas em reflexos estatísticos, esses modelos ganham tempo para deliberar, testar hipóteses, retroceder quando encontram falhas lógicas (backtracking) e validar conclusões antes de exibir o primeiro caractere ao usuário final.
Essa mudança não é um mero incremento cosmético de métricas de referência; trata-se da transição formal do “Sistema 1” (rápido, intuitivo e sujeito a ilusões) para o “Sistema 2” (lento, analítico, deliberativo e auditável), redefinindo o papel da IA no desenvolvimento de software de missão crítica, na prova de teoremas e no design de arquiteturas corporativas.
O Esgotamento do Sistema 1: Por Que a Predição Estocástica Falha em Problemas Complexos
Para compreender a magnitude dessa virada, é preciso analisar como os Large Language Models (LLMs) tradicionais — como GPT-4o, Claude 3.5 Sonnet ou Gemini 1.5 Pro — processam dados. Eles operam essencialmente como máquinas autorregressivas puras de passagem única (single-pass). Ao receber uma entrada, o modelo gera sequencialmente cada token com base na distribuição condicional de probabilidades aprendida:
$$P(w_t \mid w_1, w_2, \dots, w_{t-1})$$
Esse método funciona com fluidez excepcional para tradução, resumo, redação criativa e geração de scripts padronizados. Contudo, em desafios que exigem encadeamento lógico estrito (como verificação de condições de corrida em sistemas concorrentes, resolução de matrizes ou depuração de algoritmos NP-difíceis), o modelo autorregressivo tradicional comete um erro fatal de projeto: ele não pode “pensar antes de falar”.
Quando um modelo tradicional inicia um raciocínio por um caminho logicamente inviável, o determinismo autorregressivo o força a sustentar o erro para manter a coerência textual superficial. O resultado é a clássica alucinação estrutural: código sintaticamente elegante, com bibliotecas imaginárias ou falhas semânticas graves que só se revelam em tempo de execução.
Modelos de raciocínio profundo corrigem essa falha estrutural ao desacoplar o tempo de inferência do comprimento do texto visível. Ao conceder ao modelo ciclos de processamento computacional internos (hidden reasoning tokens), a máquina ganha a capacidade de ramificar caminhos de raciocínio, avaliar a integridade dos passos intermediários e auto-corrigir suas deduções antes de sintetizar o resultado.
A Engenharia do Test-Time Compute e o Treinamento com Recompensas Verificáveis
A espinha dorsal teórica dessa revolução reside na aplicação de novas leis de escala: as Inference Scaling Laws (Leis de Escala em Tempo de Inferência). Pesquisas fundamentais demonstraram que o desempenho de um modelo em tarefas de lógica não atinge o teto apenas adicionando mais parâmetros durante o treino; ele pode crescer de forma análoga ou superior ao expandir a computação durante a própria resposta.
       Fluxo do Raciocínio Profundo (Test-Time Compute)

┌─────────────────────────────────────────────────────────────┐
│ 1. Prompt do Usuário (Problema Complexo de Lógica/Código)   │
└──────────────────────────────┬──────────────────────────────┘
                               │
                               ▼
┌─────────────────────────────────────────────────────────────┐
│ 2. Cadeia de Pensamento Interna (Tokens Ocultos de Raciocínio)│
│    ├─ Decomposição do problema em submetas                  │
│    ├─ Exploração de caminhos alternativos                   │
│    ├─ Verificação lógica e teste de hipóteses               │
│    └─ Backtracking: descarte de ramos com inconsistências   │
└──────────────────────────────┬──────────────────────────────┘
                               │
                               ▼
┌─────────────────────────────────────────────────────────────┐
│ 3. Síntese Final (Resposta Enxuta, Validada e Estruturada)  │
└─────────────────────────────────────────────────────────────┘
Essa dinâmica opera a partir de duas frentes técnicas essenciais:
1. Cadeias de Pensamento Estruturadas e Exploração em Árvore
O modelo usa tokens ocultos para implementar raciocínio encadeado (Chain-of-Thought – CoT). Em vez de um CoT linear ingênuo, a infraestrutura simula abordagens análogas ao Monte Carlo Tree Search (MCTS) ou buscas de feixe (beam search), explorando ramificações da solução. Se um passo intermediário quebra uma restrição do problema, o ramo é podado e o modelo retrocede à última premissa válida.
2. Aprendizado por Reforço com Recompensas Verificáveis (RLVR)
Para que o modelo aprenda a pensar com precisão cirúrgica sem intervenção humana a cada passo, ele é treinado via Reinforcement Learning with Verifiable Rewards (RLVR). Em domínios determinísticos como código (onde testes de unidade compilam ou falham) e matemática (onde soluções numéricas ou provas formais têm gabarito indiscutível), o modelo é penalizado severamente por passos inválidos e premiado por deduções auditáveis e econômicas. Com o tempo, o modelo desenvolve heurísticas internas robustas sobre quando aprofundar a busca e quando convergir para a resposta.
Comparativo Estrutural: LLMs Puros vs. Arquiteturas de Raciocínio Profundo
Para parametrizar a transição tecnológica, a tabela a seguir contrasta os componentes operacionais, de infraestrutura e de desempenho entre as duas abordagens.
| Dimensão Técnica | LLMs Autorregressivos Puros (ex: GPT-4o, Gemini 1.5 Pro) | Modelos de Raciocínio Profundo (OpenAI o1/o3, Gemini Thinking) |
|---|---|---|
| Mecanismo de Geração | Predição sequencial direta de saída para o usuário (passagem única). | Computação em duas fases: geração deliberativa oculta seguida da síntese de saída. |
| Controle de Computação | Fixo por token de saída; complexidade limitada à profundidade da rede neural. | Dinâmico: ajustável via orçamentos de tempo, tokens de reflexão (reasoning effort) ou parada orientada a valor. |
| Capacidade de Correção | Ausente; falhas no início do texto propagam-se autorregressivamente até o final. | Ativa; suporta backtracking, reformulação de premissas e autocrítica pré-saída. |
| Perfil de Latência | Baixa a moderada (Time-to-First-Token de centenas de milissegundos). | Alta a muito alta (Time-to-First-Token de 5 a 60+ segundos devido ao processamento interno). |
| Consumo e Faturamento | Cobrança restrita aos tokens visíveis de prompt e resposta. | Cobrança expandida: tokens de pensamento (thinking tokens) são computados no custo total. |
| Comportamento em Código | Excelente em boilerplate, APIs padrão e scripts conhecidos; falha em edge cases sutis. | Alta precisão em refatoração multinível, concorrência, provas de correção e benchmarks formais (SWE-bench). |
| Aderência a Prompts | Sofre com prompts longos e instruções complexas ou conflitantes. | Elevada tolerância a restrições complexas; analisa e valida cada regra explicitada. |
O Ecossistema de Modelos: O Avanço de OpenAI o1/o3 e Gemini 3.7 Thinking
O cenário atual divide-se em estratégias complementares de engenharia adotadas pelas principais organizações do setor:
A Linha o1 e o3 da OpenAI
A OpenAI inaugurou a implementação comercial dessa metodologia com a família o1 (o1-preview, o1-mini e o1), consolidando saltos expressivos em olimpíadas de matemática (como a AIME) e programações competitivas (Codeforces). Enquanto os LLMs convencionais pontuavam frequentemente abaixo do percentil 50 em testes de pós-graduação em física e química teórica, o o1 alcançou marcas próximas a especialistas humanos.
O sucessor o3 elevou a fronteira computacional ao atingir desempenhos recordes no benchmark ARC-AGI (Abstraction and Reasoning Corpus) e resolver problemas complexos de engenharia de software dentro do SWE-bench Verified, provando que alocar mais poder computacional em tempo de inferência supera o ganho de apenas inflar os parâmetros estáticos do modelo base.
A Resposta do Google: Gemini 3.7 Thinking e Modelos Híbridos
O Google DeepMind adotou uma abordagem convergente com a linhagem Gemini Thinking (iniciada com Gemini 2.0 Flash Thinking e consolidada em arquiteturas de escala como Gemini 3.7 Thinking). O diferencial arquitetural do Google é a tentativa de unificar em um mesmo modelo a agilidade multimodal nativa com a capacidade de ativar orçamentos de pensamento controlados pelo desenvolvedor (dynamic thinking budget).
Essa flexibilidade permite aos engenheiros alternar dinamicamente entre respostas rápidas e sessões de raciocínio profundo na mesma malha de infraestrutura, contornando a necessidade de manter dois pipelines de modelos completamente isolados na esteira de produção.
Implementação Prática: Configurando Orçamentos de Raciocínio via API
Para arquitetos de software e desenvolvedores, interagir com modelos de raciocínio profundo exige a gestão explícita do orçamento computacional (reasoning effort ou thinking budget). Forçar o modelo a pensar demais em problemas triviais eleva os custos de nuvem desnecessariamente; restringir os tokens de pensamento em problemas complexos induz cortes prematuros na árvore de busca lógica.
Abaixo, apresentamos uma implementação funcional e segura em Python utilizando o SDK oficial da OpenAI, demonstrando como parametrizar o esforço de raciocínio em uma rotina de análise estática de segurança e verificação de condições de corrida em código assíncrono.
import os
import sys
from openai import OpenAI
from openai import APIError, RateLimitError

def analisar_codigo_critico(codigo_fonte: str, nivel_esforco: str = "high") -> str:
    """
    Submete um trecho de código a um modelo de raciocínio profundo (o1),
    configurando o orçamento deliberativo via parâmetro reasoning_effort.

    Parâmetros:
        codigo_fonte (str): O código a ser auditado contra concorrência e falhas de memória.
        nivel_esforco (str): 'low', 'medium' ou 'high' (alocação de Test-Time Compute).

    Retorna:
        str: Parecer técnico detalhado e correções verificadas.
    """
    api_key = os.getenv("OPENAI_API_KEY")
    if not api_key:
        raise ValueError("A variável de ambiente OPENAI_API_KEY não está configurada.")

    client = OpenAI(api_key=api_key)

    prompt_analise = f"""
Você é um auditor sênior de segurança de sistemas de alta concorrência.
Analise detalhadamente o código a seguir.

Requisitos obrigatórios:
1. Identifique condições de corrida, contenção de locks ou vazamentos de memória.
2. Formule casos de borda matematicamente prováveis onde o código falha.
3. Forneça o código reescrito e otimizado com garantias formais de corretude.

Código para análise:
{codigo_fonte}
"""

    try:
        # Chamada ao modelo de raciocínio o1 com especificação de esforço
        response = client.chat.completions.create(
            model="o1",
            messages=[
                {
                    "role": "user",
                    "content": prompt_analise
                }
            ],
            # Controla a quantidade de tokens internos dedicados ao Test-Time Compute
            # Opções válidas: 'low', 'medium', 'high'
            reasoning_effort=nivel_esforco
        )

        conteudo = response.choices[0].message.content
        if not conteudo:
            return "O modelo concluiu o ciclo de raciocínio, mas não gerou saída textual visível."

        # Metadados de telemetria de tokens
        uso = response.usage
        tokens_pensamento = getattr(uso.completion_tokens_details, 'reasoning_tokens', 0)

        print(f"[Telemetria] Tokens de Raciocínio (Ocultos): {tokens_pensamento}")
        print(f"[Telemetria] Tokens de Saída (Visíveis): {uso.completion_tokens - tokens_pensamento}")
        print(f"[Telemetria] Total de Tokens Faturados: {uso.total_tokens}\n")

        return conteudo

    except RateLimitError:
        print("Limite de requisições excedido. Verifique sua cota de Test-Time Compute.", file=sys.stderr)
        raise
    except APIError as e:
        print(f"Erro na execução da API: {e.message}", file=sys.stderr)
        raise

if __name__ == "__main__":
    # Exemplo com problema clássico de double-checked locking falho
    codigo_teste = """
class CacheSeguro:
    def __init__(self):
        self._instancia = None
        self._lock = False

    def obter_recurso(self):
        if self._instancia is None:
            while self._lock:
                pass  # Spinlock ingênuo sem barreiras de memória
            self._lock = True
            if self._instancia is None:
                self._instancia = self._alocar_recurso_pesado()
            self._lock = False
        return self._instancia

    def _alocar_recurso_pesado(self):
        return {"status": "iniciado", "buffer": bytearray(1024 * 1024)}
"""
    try:
        resultado = analisar_codigo_critico(codigo_teste, nivel_esforco="medium")
        print("--- PARECER DE ENGENHARIA ---")
        print(resultado)
    except Exception as err:
        print(f"Falha operacional: {err}")
Nesse padrão de consumo, o desenvolvedor precisa estar atento à chave completion_tokens_details.reasoning_tokens. O faturamento computacional engloba tanto a reflexão oculta quanto a resposta visível, tornando a seleção do modelo e de seu nível de esforço um critério prioritário de engenharia financeira (FinOps para IA).
Os Trade-offs Operacionais: Latência, Custos e Cenários de Contraindicação
O raciocínio profundo não substitui os modelos convencionais em todos os domínios; ele redefine o portfólio de ferramentas do ecossistema tecnológico. Integrar o1, o3 ou Gemini Thinking sem critério de arquitetura acarreta gargalos severos:
- A Barreira da Latência Humana: Em experiências conversacionais interativas (chatbots de suporte ao cliente, preenchimento automático de código em IDEs), um atraso de 15 a 45 segundos aguardando o processamento do Sistema 2 destrói a usabilidade. O modelo convencional, veloz e direto, continua sendo a escolha correta para tarefas transacionais simples.
- Impacto Orçamentário Exponencial: Como os tokens de raciocínio ocultos consomem computação contínua da infraestrutura de IA, uma única consulta complexa pode consumir centenas de milhares de tokens internos, custando dezenas de vezes mais que uma chamada ao GPT-4o ou Gemini Flash.
- Inadequação para Tarefas Não Determinísticas: O ganho de desempenho em raciocínio profundo cai substancialmente em tarefas que dependem de fluência estilística, edição de texto livre, brainstorming criativo ou extração direta de dados a partir de documentos estruturados. O Sistema 2 brilha onde há verdades lógicas, matemáticas ou algorítmicas comprováveis.
A governança ideal de inteligência artificial em empresas maduras adota, portanto, um padrão de roteamento inteligente de modelos (Model Routing): tarefas simples e que exigem baixa latência fluem por LLMs tradicionais; enquanto desafios de lógica, cálculos financeiros, auditorias de segurança e validações de código são direcionados a nós de raciocínio profundo com orçamentos computacionais devidamente calibrados.
💬 Participe da Discussão: Como a sua equipe tem lidado com o trade-off entre a alta latência dos modelos de raciocínio profundo e a necessidade de respostas deterministicamente seguras no desenvolvimento de software?
Perguntas Frequentes (FAQ)
O que são exatamente os tokens de raciocínio (reasoning tokens) nesses modelos?
São tokens gerados internamente pela rede neural durante a etapa deliberativa oculta da inferência. O usuário final não os vê na resposta primária, mas eles representam o trabalho computacional em que o modelo decompõe o problema, simula hipóteses, realiza verificações e descarta premissas incorretas antes de entregar a resposta definitiva.
Qual é a diferença fundamental entre usar o prompt “pense passo a passo” (CoT) e usar o o1 ou Gemini Thinking?
Instruir um LLM tradicional a “pensar passo a passo” (Chain-of-Thought manual) força o modelo a cuspir seu raciocínio linearmente no canal de saída visível, sem poder voltar atrás se errar um cálculo no meio do caminho. Modelos de raciocínio profundo realizam buscas complexas com retrocesso (backtracking), avaliam hipóteses internamente e foram otimizados via aprendizado por reforço para descartar caminhos falhos antes da geração da resposta.
Os modelos de raciocínio profundo eliminam completamente as alucinações?
Não, mas reduzem drasticamente as alucinações de natureza lógica e algorítmica. O modelo ainda pode incorrer em alucinações se o problema depender de dados fáticos de conhecimento geral que ele desconhece ou se as premissas enviadas no prompt estiverem incorretas. No entanto, em tarefas de dedução passo a passo, a incidência de falhas lógicas é significativamente menor.
Por que o tempo de resposta (Time-to-First-Token) desses modelos é muito superior ao dos LLMs comuns?
Porque a geração do primeiro token visível depende do término de todo o ciclo de reflexão interna (Test-Time Compute). Enquanto um LLM tradicional começa a emitir texto após alguns milissegundos de processamento do prompt, os modelos de raciocínio dedicam segundos ou até minutos explorando caminhos na cadeia de pensamento oculta antes de compor a resposta para o usuário.
Quando devo escolher um LLM tradicional em vez de um modelo como o1, o3 ou Gemini Thinking?
Modelos tradicionais continuam sendo a escolha ideal para sumarização de textos, redação criativa, tradução, extração simples de entidades, atendimento em tempo real ao cliente e autocompletar código em IDEs. Modelos de raciocínio profundo devem ser reservados para refatoração de sistemas complexos, depuração de concorrência, provas matemáticas, validações de contratos legais com regras estritas e planejamento autônomo de agentes.
Artigo redigido e contextualizado por Rodrigo Batista para o portal IA na Prática Digital, com base em comunicados e análises técnicas sobre IA na Prática Digital.
Faça parte dos nossos grupos exclusivos no WhatsApp e Telegram!
Entre nos grupos oficiais de Achadinhos & Ofertas para receber cupons testados, promoções relâmpago da Shopee e Mercado Livre com até 80% de desconto e novidades de inteligência artificial em primeira mão direto no seu celular: