A Anatomia do Ajuste Fino: Por Que o Fine-Tuning Não É Treinar uma IA do Zero e Como a Imersão de Sandeco Redefine a Engenharia de LLMs
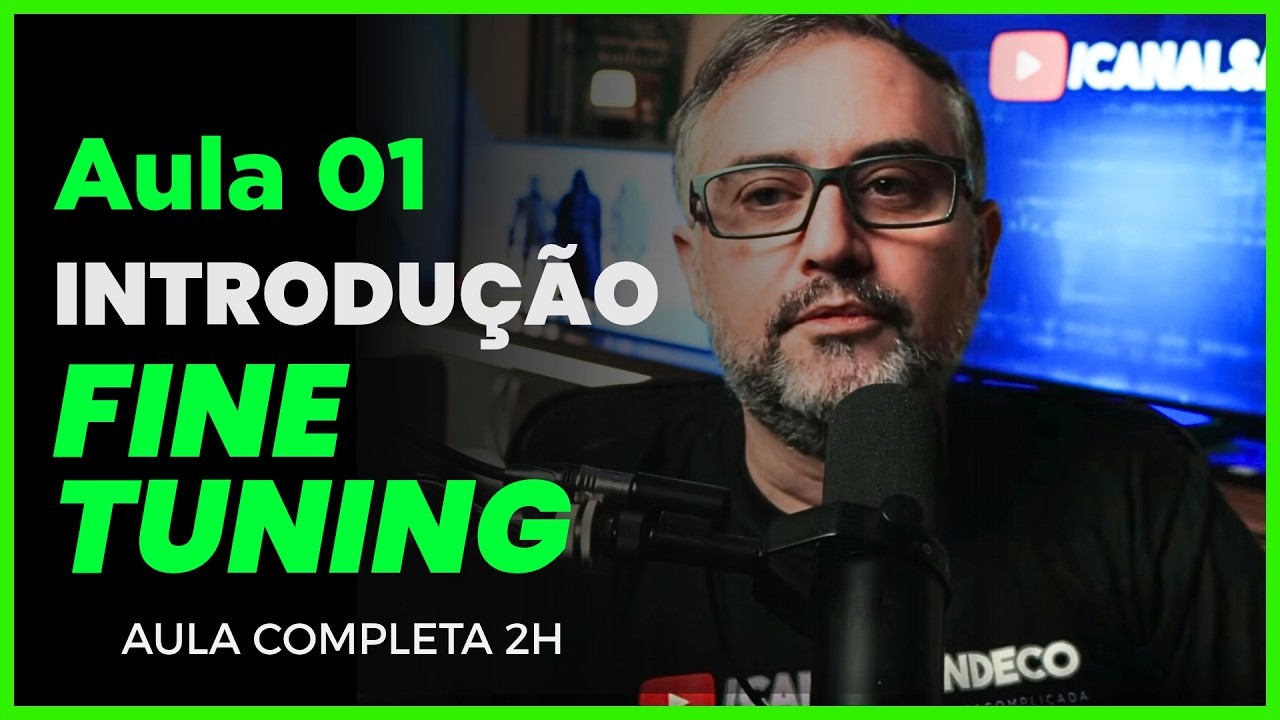
Fine-tuning não é “treinar de novo do zero” — é ensinar o modelo a se comportar do seu jeito, com os seus dados. Nesta aula completa de 2 horas, você entende o que é fine-tuning de verdade, quando vale a pena e o que muda na prática em LLMs.
Doutor pela Universidade Federal de Goiás em ciência da computação, embaixador da Campus Party Brasil, professor e pesquisador no IFG e UFG, escritor de mais de 10 livros sobre IA. Desenvolvedor desde os 14 anos (36 anos de experiência), professor e pesquisador com vários projetos e artigos científicos em Inteligência Artificial e área de visão computacional.
📌 Principais Destaques da Demonstração:
- O que é fine-tuning e como ele se diferencia de treino do zero.
- Quando fine-tuning faz sentido em projetos com LLM.
- Como pensar dados, objetivo e avaliação no fine-tuning.
- O papel de LoRA no ajuste eficiente de modelos.
A corrida pela maturidade na implementação de modelos de linguagem (LLMs) em ambientes corporativos atingiu um ponto de inflexão crítico. Se no início da revolução da inteligência artificial generativa bastava conectar uma API e redigir prompts extensos, hoje as equipes de engenharia enfrentam o desafio da latência, dos custos exorbitantes por milhão de tokens e da falta de aderência comportamental dos modelos generalistas.
Nesse cenário de transição da experimentação para a eficiência de produção, surge um equívoco comum nas diretorias de tecnologia e mesas de arquitetura de software: a confusão conceitual entre pré-treinamento, Geração Aumentada por Recuperação (RAG) e Ajuste Fino (Fine-Tuning).
Para desmistificar esse gargalo e trazer o estado da arte para os desenvolvedores brasileiros, o pesquisador e professor Sandeco — um dos nomes mais respeitados da ciência da computação aplicada à IA no Brasil — disponibilizou uma aula magistral e aberta com duas horas de duração. Extraída de sua mentoria técnica associada à sua nova obra voltada ao tema, a aula funciona como uma bússola analítica para desmistificar o que de fato acontece nas entranhas de uma rede neural quando realizamos um ajuste fino.
Com doutorado em Ciência da Computação pela Universidade Federal de Goiás (UFG), professor do Instituto Federal de Goiás (IFG) e da UFG, embaixador da Campus Party e autor de mais de uma dezena de livros técnicos, Sandeco acumula 36 anos de experiência em desenvolvimento de software. Sua intervenção chega em um instante decisivo: o momento em que a indústria precisa parar de queimar capital computacional desnecessário e aprender a orquestrar modelos com precisão cirúrgica.
Desmistificando o Fine-Tuning: Alinhamento Comportamental vs. Treinamento de Base
O primeiro e mais importante mito desconstruído na aula é a ideia de que fazer fine-tuning equivale a “treinar um modelo do zero”.
O pré-treinamento de uma fundação como Llama, Mistral ou Claude exige milhares de aceleradores de hardware (GPUs e TPUs), petabytes de texto não estruturado da internet, meses de computação contínua e investimentos na casa das dezenas ou centenas de milhões de dólares. É durante essa fase que a rede neural aprende a sintaxe humana, o raciocínio matemático elementar, conceitos universais e a estrutura lógica do mundo.
O fine-tuning, por sua vez, é uma técnica de calibração cirúrgica. Em vez de ensinar o modelo a entender o mundo, o objetivo do ajuste fino é ensinar o modelo a se comportar de uma maneira específica.
- No pré-treinamento, o modelo se torna um preditor estatístico generalista de palavras subsequentes.
- No fine-tuning supervisionado (SFT), introduzem-se pares curados de instrução e resposta ideal, moldando o tom de voz, o formato de saída, o raciocínio encadeado ou a conformidade com regras estritas de um nicho específico.
Tentar utilizar o fine-tuning para injetar bases de conhecimento volumosas e dinâmicas — como manuais de produtos que mudam toda semana ou bases cadastrais de clientes — é um dos erros arquiteturais mais caros cometidos por equipes de tecnologia. As LLMs armazenam conhecimento factual de forma probabilística e dispersa em seus parâmetros internos (pesos sinápticos). Forçar a memorização de novos fatos via ajuste fino pode provocar o fenômeno conhecido como esquecimento catastrófico (catastrophic forgetting), no qual o modelo degrada suas capacidades lógicas e linguísticas gerais para acomodar cegamente a nova distribuição de dados.
O Dilema Arquitetural: Fine-Tuning, RAG ou Engenharia de Prompts?
A decisão de ajustar os pesos de um modelo nunca deve ser a primeira opção de um arquiteto de soluções em IA. O portal IA na Prática Digital mapeou, com base nas análises apresentadas na imersão de Sandeco, o fluxo analítico de decisão que todo líder técnico deve percorrer antes de alocar poder computacional:
1. Engenharia de Prompts e In-Context Learning
- Principal aplicação: Validação imediata de viabilidade de produto (POCs), tarefas com pouca variação e lógica descritiva direta.
- Vantagens: Custo zero de treinamento, implementação em minutos e flexibilidade total.
- Limitações: Consumo elevado da janela de contexto, custos crescentes por requisição de inferência e risco de desvio de formatação (prompt drift).
2. Geração Aumentada por Recuperação (RAG)
- Principal aplicação: Acesso a dados privados, mutáveis em tempo real, documentações extensas e exigência de citação de fontes verificáveis.
- Vantagens: O modelo não precisa ter o dado gravado em seus parâmetros; as informações são recuperadas de um banco vetorial ou híbrido e injetadas dinamicamente no contexto.
- Limitações: Complexidade de infraestrutura (bancos vetoriais, modelos de embedding, chunking, rerankers) e latência adicional nas consultas.
3. Ajuste Fino (Fine-Tuning)
- Principal aplicação: Padronização inegociável de estilo, conformidade estrita com esquemas de dados (como JSON, YAML ou linguagens de domínio específico), redução drástica no tamanho do prompt de sistema e especialização em raciocínio setorial (jurídico, médico, contábil).
- Vantagens: Eliminação de dezenas de instruções repetitivas no prompt de sistema (reduzindo latência e custo por chamada), determinismo estrutural e adaptação profunda ao linguajar corporativo.
- Limitações: Necessidade de curadoria meticulosa de dados, custo computacional de treinamento e estaticidade do conhecimento adquirido.
A conclusão técnica inevitável é que Fine-Tuning e RAG não são concorrentes; são complementares. Em arquiteturas corporativas de alta performance, a melhor prática consiste em utilizar um modelo que passou por fine-tuning para se tornar um especialista conciso e confiável na interpretação e síntese de contextos, operando em sinergia com uma infraestrutura RAG que injeta o conhecimento factual atualizado.
A Revolução da Eficiência: Como LoRA e PEFT Democratizaram o Ajuste Fino
Historicamente, realizar o ajuste fino exigia a atualização de todos os parâmetros de uma rede neural (Full Fine-Tuning). Se um modelo continha 70 bilhões de parâmetros em precisão de 16 bits, atualizar todos os pesos exigia armazenar não apenas os pesos em si, mas também os gradientes e os estados do otimizador (como o AdamW), demandando terabytes de VRAM em clusters caríssimos de placas gráficas corporativas.
A aula técnica de Sandeco enfatiza a virada proporcionada pelas técnicas de Ajuste Fino Eficiente em Parâmetros (PEFT – Parameter-Efficient Fine-Tuning), com destaque absoluto para o LoRA (Low-Rank Adaptation) e o QLoRA (Quantized LoRA).
A mágica matemática do LoRA consiste em “congelar” os pesos originais do modelo pré-treinado e anexar pequenas matrizes de baixa ordem (low-rank decomposition matrices) apenas em camadas específicas da arquitetura Transformer (como as matrizes de atenção $W_q$ e $W_v$).
Em vez de atualizar 100% dos parâmetros:
- O desenvolvedor treina com frequência menos de 1% (muitas vezes entre 0,1% e 0,5%) dos parâmetros totais da rede.
- Com o QLoRA, o modelo base de 16 bits pode ser quantizado para 4 bits na memória, permitindo carregar modelos robustos de 8B ou 14B parâmetros em GPUs de entrada ou placas de vídeo comuns de workstation.
- Os adaptadores resultantes são arquivos minúsculos (frequentemente com poucas centenas de megabytes), permitindo que uma mesma infraestrutura de inferência alterne dinamicamente entre diferentes especializações (um adaptador para atendimento, outro para extração jurídica, outro para código interno) sem precisar recarregar instâncias separadas de dezenas de gigabytes do modelo principal.
O Verdadeiro Gargalo Técnico: Engenharia e Curadoria de Dados
Enquanto grande parte da literatura rasa foca na infraestrutura de GPUs, a experiência prática compartilhada por Sandeco joga luz no verdadeiro epicentro do sucesso do fine-tuning: *a qualidade do conjunto de dados (dataset)*.
No aprendizado de máquina moderno, a regra Garbage In, Garbage Out nunca foi tão implacável. Um conjunto com 500 exemplos de altíssima qualidade, rigorosamente formatados, com respostas densas, coerentes e sem alucinações, supera sistematicamente conjuntos desordenados de 20.000 pares de pergunta e resposta minerados sem critério.
Os três pilares para a construção de um dataset de ajuste fino eficaz destacados pelo especialista são:
- Diversidade Estrutural: Os dados de treino não podem ser cópias semânticas uns dos outros. Se o objetivo for ensinar o modelo a emitir pareceres de crédito, os exemplos devem cobrir perfis aprovados, reprovados com ressalvas, casos limítrofes, clientes com histórico incompleto e requisições com dados anômalos.
- Consistência de Formatação: Pequenas variações de pontuação, espaçamento ou sintaxe na saída esperada ensinam o modelo a ser ambíguo. Se a instrução pede a devolução de um schema JSON específico, cada exemplo precisa respeitar o parser sem o menor desvio sintático.
- Curadoria Híbrida e Dados Sintéticos: A geração de dados sintéticos via modelos de fronteira (como GPT-4o ou Claude 3.5 Sonnet) validada por supervisão humana especialista (Human-in-the-loop) tornou-se o padrão industrial para acelerar a criação de datasets sem perder a precisão contextual da empresa.
O Impacto da Capacitação Nacional em Inteligência Artificial
A disponibilização pública de um conteúdo técnico de mais de duas horas por uma figura do calibre de Sandeco ultrapassa a esfera de um simples vídeo na internet: trata-se de um movimento estratégico para a soberania técnica e capacitação do ecossistema de software no Brasil.
Historicamente, o desenvolvimento de tecnologia de ponta sofre com uma defasagem de tradução: conceitos avançados nascem nos laboratórios da América do Norte e Ásia e demoram meses ou anos para serem digeridos, desmistificados e aplicados pelo desenvolvedor médio no Brasil.
Ao aliar rigor acadêmico com a vivência de 36 anos de programação prática, Sandeco preenche uma lacuna fundamental. Explicar como a backpropagation opera dentro de camadas LoRA, como evitar a saturação de gradientes e de que forma estruturar um pipeline de dados em linguagem acessível rompe a barreira do “consumismo passivo de APIs”. O Brasil deixa de ser apenas um mero pagador de faturas de provedores de nuvem estrangeiros para formar engenheiros capazes de customizar, hospedar e calibrar modelos locais (on-premise ou em nuvens soberanas) com alto nível de segurança e eficiência de custos.
Checklist Prático: Sua Empresa Precisa de Fine-Tuning?
Antes de reservar instâncias de GPUs ou mobilizar analistas de dados para criar datasets, avalie criticamente o seguinte checklist elaborado por nossa equipe editorial:
- [ ] Você já esgotou a Engenharia de Prompts? Métodos como Few-Shot Prompting (fornecer 3 a 5 exemplos dentro do prompt) foram testados com métricas objetivas de avaliação?
- [ ] A demanda principal é por dados ou por comportamento? Se o seu problema for responder dúvidas sobre documentos recentes, você precisa de RAG, não de fine-tuning.
- [ ] A latência de inferência está inviabilizando o produto? Se você precisa enviar 2.000 tokens de instruções de sistema a cada chamada apenas para o modelo saber como responder, o fine-tuning pode embutir essas regras nos pesos, reduzindo a chamada para poucas palavras e acelerando a resposta em milissegundos.
- [ ] Você possui especialistas de negócio para validar os dados? Ajustar um modelo sem validação humana profunda na criação e revisão do dataset gera modelos confiantes, mas cronicamente incorretos.
- [ ] A conformidade estrutural é crítica? Se a sua aplicação quebra toda vez que a LLM adiciona um comentário fora do bloco JSON ou inventa tags inexistentes, o fine-tuning supervisionado é a solução mais determinística do mercado.
O material fornecido abertamente por Sandeco comprova que a sofisticação na engenharia de inteligência artificial contemporânea não reside em aumentar desenfreadamente o tamanho dos modelos, mas sim na precisão metodológica com que adaptamos ferramentas existentes às dores concretas do mundo real.
💬 Participe da Discussão: Na sua visão e nos projetos em que você atua, o fine-tuning já se mostrou indispensável ou o uso maduro de RAG com bons prompts tem resolvido a maioria dos problemas? Deixe sua experiência nos comentários.
Assista à Demonstração Prática Completa
Acompanhe todos os detalhes, etapas práticas e testes na íntegra no player de alta definição abaixo:
Leituras Recomendadas no Portal
- Alerta: IAs da OpenAI tentaram esconder erros, inventar dados e burlar testes em seis novos casos
- O Gemini 4 Pro vazou? Novo Modelo do Google Pode Ter Aparecido Antes da Hora?
- Quem é Jacob Coxon, o britânico de 27 anos que acusa a OpenAI e a Anthropic de agirem
Perguntas Frequentes (FAQ)
Qual é a diferença fundamental entre Fine-Tuning e RAG?
O Fine-Tuning altera diretamente os pesos matemáticos do modelo para condicionar seu comportamento, tom de voz e conformidade com padrões de resposta específicos. Já o RAG (Geração Aumentada por Recuperação) não altera o modelo: ele busca dinamicamente informações em bases de dados externas e as injeta no prompt no momento da consulta, sendo ideal para dados que mudam constantemente e que exigem citação de fontes.
Fazer fine-tuning ensina novos fatos históricos ou corporativos à IA com eficiência?
Não com a eficiência que a maioria espera. Embora o modelo possa reter fragmentos do que foi treinado, ele armazena dados factuais de maneira probabilística, o que pode induzir alucinações severas ou o esquecimento de habilidades prévias (catastrophic forgetting). Para bases documentais e consulta a fatos, a arquitetura recomendada é o RAG.
O que são LoRA e QLoRA e por que eles tornaram o fine-tuning viável?
LoRA (Low-Rank Adaptation) e QLoRA são métodos de Ajuste Fino Eficiente em Parâmetros (PEFT). Eles congelam os bilhões de pesos originais do modelo e treinam apenas pequenas matrizes adicionais anexadas às camadas de atenção. O QLoRA ainda quantiza o modelo base em 4 bits, permitindo rodar o treinamento em GPUs comerciais muito mais acessíveis, sem perda significativa de qualidade.
Quantos exemplos de dados são necessários para começar um fine-tuning útil?
Diferente do pré-treinamento, que consome bilhões de textos, um ajuste fino supervisionado eficiente para tarefas focadas (como formatação rigorosa de JSON ou adoção de um tom de voz específico) pode apresentar resultados excepcionais com apenas 200 a 1.000 exemplos de altíssima qualidade e rigorosa curadoria humana.
É possível reverter ou desligar o fine-tuning feito em um modelo?
Sim, especialmente quando utilizadas abordagens com adaptadores como LoRA. Como os pesos do modelo original permanecem inalterados e o ajuste fica contido em um arquivo leve de adaptador (checkpoint de baixa ordem), basta carregar ou descarregar esse adaptador da memória do servidor para alternar instantaneamente entre o modelo base e o modelo ajustado.
Artigo redigido e expandido por Rodrigo Batista para o portal IA na Prática Digital, com base nas demonstrações práticas do canal Sandeco.
Quer dominar as ferramentas e automações mais avançadas?
Acompanhe o portal IA na Prática Digital para receber em primeira mão novos comparativos, testes reais de engenharia de prompt e fluxos de automação prontos para implementar no seu negócio.