A Arquitetura Oculta dos Grafos de IA: Como o Padrão Trabalhador-Supervisor Transforma Agentes Autônomos em Sistemas Confiáveis
Grafos de IA são a forma como as autoridades em inteligência artificial constroem projetos ambiciosos — e aqui você aprende a estruturar os seus.
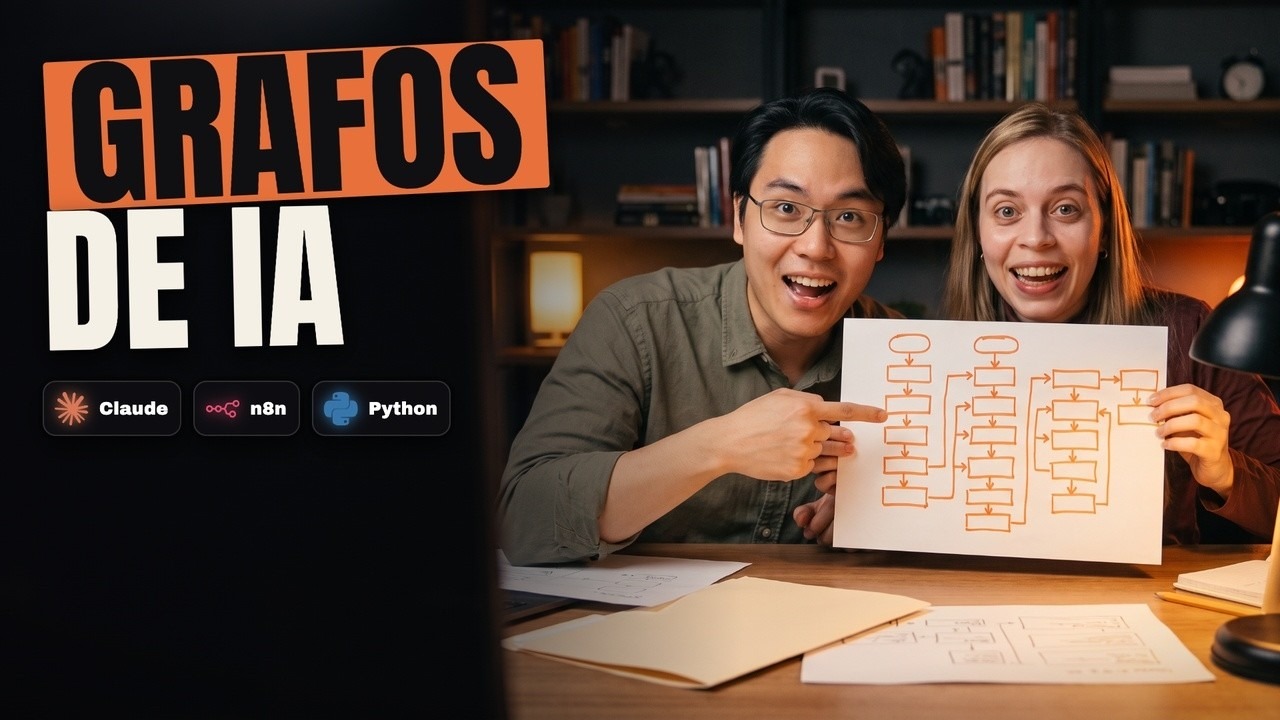
Neste vídeo eu mostro, de forma visual e do zero, como funcionam os loops (a dupla trabalhador + supervisor) e como vários loops em paralelo formam um grafo de IA: a lógica por trás dos agentes autônomos e dos sistemas agênticos que realmente funcionam. Você vai entender como definir metodologias de verificação, encadear etapas de pesquisa, scraping, front-end e back-end, e transformar tudo isso em um aplicativo real, em vez de jogar tudo em um prompt gigante e torcer pelo resultado.
O ecossistema de inteligência artificial generativa atingiu um ponto de inflexão técnica. Durante os últimos dois anos, grande parte do mercado concentrou esforços na sofisticação de prompts e no encadeamento linear de chamadas via Large Language Models (LLMs). No entanto, engenheiros de software e arquitetos de soluções deparam-se diariamente com o mesmo gargalo: cadeias estritamente lineares falham diante da menor ambiguidade, acumulam erros em cascata e são incapazes de autoavaliação crítica.
A resposta da vanguarda da engenharia de IA para essa limitação não está no aumento do tamanho do modelo fundacional, mas na estruturação do fluxo de controle computacional. É aqui que entram os Grafos de IA (State Graphs) — uma abordagem arquitetural baseada na teoria dos grafos que substitui sequências rígidas por topologias cíclicas, permitindo controle de estado granular, iterações condicionais e coordenação de múltiplos agentes.
Nesta análise profunda do IA na Prática Digital, desvendamos como os especialistas do setor estão utilizando grafos computacionais para construir sistemas autônomos de alta precisão, com foco especial no padrão arquitetural mais robusto da atualidade: a relação entre Trabalhador (Worker) e Supervisor (Evaluator/Critic).
—
O Esgotamento das Cadeias Lineares: Por Que Prompts Simples Quebram em Produção
Na engenharia de software tradicional, a computação determinística prospera sob arquiteturas de execução direta. Nos primórdios da orquestração de LLMs, ferramentas como o padrão Sequential Chain tentaram emular esse comportamento: o nó A recebia a entrada do usuário, gerava uma resposta que era injetada no nó B, que então formatava a saída para o nó C.
Em tarefas complexas — como refatoração de código legado, reconciliação contábil automatizada ou auditoria de contratos jurídicos —, a taxa de sucesso dessas cadeias despenca exponencialmente a cada etapa adicional. Se o Nó 1 alucinar com uma probabilidade de 10%, e o Nó 2 apresentar 10% de margem de erro, a confiabilidade de um fluxo linear de cinco passos cai para menos de 60%.
O problema central reside na ausência de retroalimentação (feedback loops). Quando uma função em Python falha em um ambiente convencional, lançamos uma exceção ou executamos um laço de repetição condicional (while ou retry). Até recentemente, a maioria dos fluxos baseados em IA ignorava esse princípio basilar da ciência da computação, operando como Grafos Acíclicos Direcionados (DAGs) estritos.
Os Grafos de IA rompem essa limitação ao introduzir ciclos. Ao viabilizar que o fluxo retorne a um nó anterior com base no estado computacional atualizado, a arquitetura permite que o sistema tente novamente, corrija falhas pontuais e refine sua própria saída antes de entregar o resultado ao usuário final.
—
Anatomia dos Grafos de Estado: Nós, Arestas Condicionais e Memória Compartilhada
Para compreender a mecânica por trás dessa tecnologia, é necessário decompor o Grafo de IA em seus três pilares fundamentais:
- Estado Compartilhado (State): O grafo opera sobre um esquema de dados centralizado e imutável a cada transição de estado. Cada nó lê o estado atual e retorna atualizações parciais para chaves específicas (como histórico de mensagens, código gerado, contagem de iterações e parecer de qualidade).
- Nós (Nodes): Funções computacionais autônomas. Um nó pode ser uma chamada a uma LLM especializada, uma execução de código em um sandbox isolado, uma consulta a um banco vetorial ou uma validação algorítmica de esquema JSON.
- Arestas Determinísticas e Condicionais (Edges): Enquanto as arestas fixas conduzem o fluxo invariavelmente de um nó a outro, as arestas condicionais funcionam como roteadores dinâmicos. Elas avaliam o estado computacional e decidem a próxima etapa do grafo com base em regras lógicas ou na inferência de um modelo supervisor.
Essa modelagem transforma o agente de IA em uma Máquina de Estados Finitos Estendida, trazendo previsibilidade, observabilidade e contenção de erros para sistemas não determinísticos.
—
O Ciclo Trabalhador-Supervisor: Engenharia de Loop em Ação
Dentre os padrões emergentes em grafos de IA, a díade Trabalhador + Supervisor consolidou-se como o padrão de ouro para tarefas que exigem rigor técnico.
O Papel do Trabalhador (Worker)
O Trabalhador é o componente executor. Ele não precisa possuir uma visão holística da estratégia global do sistema. Sua atribuição consiste em receber uma tarefa bem definida, o histórico de tentativas anteriores e as notas de feedback geradas no ciclo anterior. Com essas entradas, ele sintetiza uma nova versão do artefato (seja um texto técnico, um script ou uma consulta SQL).
O Papel do Supervisor (Evaluator/Router)
O Supervisor atua como o controlador de qualidade e árbitro do fluxo. Ele é configurado com parâmetros rigorosos de aceitação (rubricas de avaliação, testes unitários ou verificadores sintáticos). Ao receber o artefato do Trabalhador, o Supervisor executa uma análise crítica:
- Se o artefato atender aos requisitos, o Supervisor direciona a aresta para a conclusão do grafo.
- Se o artefato contiver erros conceituais, falhas de sintaxe ou inconsistências, o Supervisor gera um relatório detalhado de correções, incrementa o contador de iterações do estado e roteia a execução de volta para o Trabalhador.
Essa divisão de responsabilidades simula a dinâmica de um engenheiro júnior produzindo um Pull Request e um engenheiro sênior realizando o Code Review. O modelo não tenta acertar tudo em um único disparo; ele converge para a resposta correta por aproximações sucessivas orientadas por feedback.
—
Comparativo Estrutural: Cadeias Lineares, DAGs e Grafos de Estado
A escolha da topologia de software define a robustez de um sistema de IA em produção. A tabela a seguir sintetiza as diferenças técnicas entre as abordagens predominantes:
| Parâmetro de Engenharia | Cadeias Lineares (Chains) | Grafos Acíclicos (DAGs) | Grafos de Estado Cíclicos (State Graphs) |
|---|---|---|---|
| Topologia do Fluxo | Sequencial unidirecional | Ramificada e convergente (sem loops) | Cíclica, com bifurcações e retornos |
| Capacidade de Autorreparo | Inexistente (falha catastrófica no nó) | Limitada a fallbacks pré-programados | Alta (iteração com feedback contextual) |
| Gerenciamento de Estado | Transitório (passado nó a nó) | Centralizado por pipeline | Centralizado com histórico de mutações e checkpointing |
| Complexidade de Depuração | Baixa | Moderada | Alta (requer rastreamento de estados/iterações) |
| Consumo de Tokens | Previsível e estático | Previsível por ramificação | Dinâmico (dependente da convergência do loop) |
| Intervenção Humana (Human-in-the-Loop) | Rígida (apenas no início/fim) | Pontual entre nós lineares | Nativa (pausa em qualquer nó do ciclo) |
| Caso de Uso Ideal | Classificação direta e tradução | Pipelines ETL de dados enriquecidos com IA | Geração de código, auditoria profunda e escrita autônoma |
—
Guia Prático de Implementação: Criando um Grafo Trabalhador-Supervisor em Python
Para demonstrar a mecânica exata de um Grafo de IA, estruturamos uma implementação completa utilizando o framework LangGraph integrado ao ecossistema da LangChain.
O script abaixo simula um sistema de geração de documentação técnica. O Trabalhador gera um rascunho com base em um tema, e o Supervisor avalia se o conteúdo cumpre diretrizes rígidas de qualidade. Caso reprovado, o rascunho retorna ao Trabalhador com instruções de revisão, com limite estrito de recursão para evitar gastos desnecessários com tokens.
Pré-requisitos
Instale os pacotes necessários em seu ambiente virtual:
pip install langgraph langchain-core langchain-openai python-dotenvCrie um arquivo .env na raiz do diretório com sua chave de autenticação:
OPENAI_API_KEY=sua_chave_aquiScript Executável (worker_supervisor_graph.py)
import os
import sys
from typing import TypedDict, Literal
from dotenv import load_dotenv

from langchain_core.messages import HumanMessage, SystemMessage
from langchain_openai import ChatOpenAI
from langgraph.graph import StateGraph, START, END

# Carrega variáveis de ambiente
load_dotenv()

if not os.getenv("OPENAI_API_KEY"):
    print("ERRO: A variável de ambiente OPENAI_API_KEY não foi encontrada no arquivo .env.")
    sys.exit(1)

# 1. Definição do Esquema de Estado Compartilhado
class AgentState(TypedDict):
    tema: str
    conteudo_gerado: str
    feedback_supervisor: str
    status_aprovacao: bool
    iteracoes: int
    limite_maximo_iteracoes: int

# 2. Inicialização dos Modelos
# Utilizamos modelos com temperatura baixa para máxima aderência estrutural
modelo_llm = ChatOpenAI(model="gpt-4o-mini", temperature=0.2)

# 3. Definição do Nó Trabalhador (Worker)
def no_trabalhador(state: AgentState) -> dict:
    """Gera ou refina o conteúdo técnico baseado no tema e no feedback acumulado."""
    print(f"\n[TRABALHADOR] Iniciando ciclo de produção (Iteração {state['iteracoes'] + 1})...")

    mensagens = [
        SystemMessage(
            content=(
                "Você é um redator técnico de engenharia de software de alta precisão. "
                "Escreva uma explicação técnica concisa e aprofundada sobre o tema fornecido. "
                "Se houver feedback de revisão anterior, corrija todos os pontos estritamente."
            )
        ),
        HumanMessage(
            content=(
                f"Tema: {state['tema']}\n"
                f"Conteúdo Anterior: {state['conteudo_gerado']}\n"
                f"Feedback do Supervisor: {state['feedback_supervisor']}"
            )
        )
    ]

    try:
        resposta = modelo_llm.invoke(mensagens)
        novo_conteudo = str(resposta.content)
    except Exception as erro:
        novo_conteudo = f"Falha na chamada da API: {str(erro)}"

    return {
        "conteudo_gerado": novo_conteudo,
        "iteracoes": state["iteracoes"] + 1
    }

# 4. Definição do Nó Supervisor (Evaluator)
def no_supervisor(state: AgentState) -> dict:
    """Avalia o conteúdo técnico gerado sob critérios estritos de completude."""
    print("[SUPERVISOR] Analisando a qualidade técnica do artefato gerado...")

    criterios = (
        "O texto deve: 1) Definir claramente o conceito; 2) Explicar ao menos um benefício prático; "
        "3) Ter tom estritamente profissional e analítico sem clichês de autoajuda. "
        "Se cumprir todos os critérios, responda apenas: 'STATUS: APROVADO'. "
        "Se não cumprir, inicie com 'STATUS: REPROVADO' e liste o motivo objetivo da correção."
    )

    mensagens = [
        SystemMessage(content=f"Você é um auditor sênior de documentação técnica. Critérios:\n{criterios}"),
        HumanMessage(content=f"Conteúdo avaliado:\n{state['conteudo_gerado']}")
    ]

    try:
        analise = modelo_llm.invoke(mensagens)
        parecer = str(analise.content)
    except Exception as erro:
        parecer = f"STATUS: REPROVADO - Erro durante auditoria: {str(erro)}"

    aprovado = "STATUS: APROVADO" in parecer

    return {
        "feedback_supervisor": parecer,
        "status_aprovacao": aprovado
    }

# 5. Lógica de Roteamento Condicional (Aresta Condicional)
def roteador_pos_supervisor(state: AgentState) -> Literal["trabalhador", "__end__"]:
    """Decide se o fluxo encerra ou retorna para nova rodada de ajustes."""
    if state["status_aprovacao"]:
        print("\n✅ [SUPERVISOR] Parecer favorável: Artefato APROVADO.")
        return END

    if state["iteracoes"] >= state["limite_maximo_iteracoes"]:
        print("\n⚠️ [SISTEMA] Limite máximo de iterações atingido. Forçando encerramento.")
        return END

    print("\n🔄 [SUPERVISOR] Parecer desfavorável. Devolvendo tarefa ao Trabalhador...")
    return "trabalhador"

# 6. Compilação do Grafo de Estados
builder = StateGraph(AgentState)

# Inclusão dos Nós
builder.add_node("trabalhador", no_trabalhador)
builder.add_node("supervisor", no_supervisor)

# Definição das Arestas
builder.add_edge(START, "trabalhador")
builder.add_edge("trabalhador", "supervisor")
builder.add_conditional_edges(
    "supervisor",
    roteador_pos_supervisor,
    {
        "trabalhador": "trabalhador",
        END: END
    }
)

# Compila o grafo executável
grafo_executavel = builder.compile()

# 7. Bloco de Execução Principal
if __name__ == "__main__":
    print("=" * 70)
    print("PORTAL IA NA PRÁTICA DIGITAL - EXECUÇÃO DE GRAFO DE IA")
    print("=" * 70)

    estado_inicial: AgentState = {
        "tema": "Arquitetura de microsserviços orientada a eventos (EDA) com Apache Kafka",
        "conteudo_gerado": "",
        "feedback_supervisor": "Nenhum feedback inicial. Gere a primeira versão do documento.",
        "status_aprovacao": False,
        "iteracoes": 0,
        "limite_maximo_iteracoes": 3
    }

    try:
        resultado = grafo_executavel.invoke(estado_inicial)

        print("\n" + "=" * 70)
        print("RESULTADO FINAL DO PROCESSO")
        print("=" * 70)
        print(f"Total de iterações executadas: {resultado['iteracoes']}")
        print(f"Status de Aprovação: {resultado['status_aprovacao']}")
        print(f"\nParecer Final do Supervisor:\n{resultado['feedback_supervisor']}")
        print(f"\nConteúdo Final Consolidado:\n{resultado['conteudo_gerado']}")
        print("=" * 70)
    except Exception as e:
        print(f"\nErro crítico durante a execução do grafo: {str(e)}")
—
Gestão de Riscos, Recursão Infinita e Observabilidade em Produção
Embora os Grafos de IA ofereçam resiliência sem precedentes, eles introduzem desafios operacionais que a engenharia de software tradicional conhece sob a disciplina de SRE (Site Reliability Engineering):
1. Prevenção de Loops Infinitos e Explosão de Custos
Em sistemas cíclicos, uma divergência entre a expectativa do Supervisor e a capacidade de entrega do Trabalhador pode prender o sistema em uma recursão infinita. Cada iteração consome tokens de entrada e saída. Portanto, o estabelecimento de um parâmetro recursion_limit no grafo ou de um contador explícito de controle no estado compartilhado é mandatório em qualquer ambiente corporativo.
2. Time-Travel e Checkpointing de Estado
Frameworks de grafos contemporâneos oferecem suporte a persistência nativa (checkpointers via SQLite, PostgreSQL ou Redis). Esse recurso permite pausar a execução após a análise do Supervisor, salvar o snapshot do estado e aguardar a aprovação de um operador humano (padrão Human-in-the-Loop). Se um humano rejeitar a ação, o estado pode retroceder a uma versão anterior para exploração de um ramo alternativo da árvore computacional.
3. Latência vs. Confiabilidade
A troca técnica (trade-off) é evidente: um fluxo linear responde em 2 a 4 segundos, mas carrega alta variabilidade de acerto. Um grafo cíclico com validação pode levar de 15 a 45 segundos para convergir, porém entrega uma taxa de conformidade drasticamente superior. Para aplicações de missão crítica — como análise regulatória, finanças ou implantação de código —, a latência adicional é o preço natural da precisão.
—
💬 Participe da Discussão: Na sua organização, os fluxos de IA ainda dependem de cadeias lineares simples ou você já está implementando grafos de estado com loops de autorreflexão e supervisão? Compartilhe seus desafios de arquitetura!
—
Assista à Demonstração Prática Completa
Acompanhe todos os detalhes, etapas práticas e testes na íntegra no player de alta definição abaixo:
Leituras Recomendadas no Portal
- Trump e Nvidia Acabam de Mandar Um Recado Para Quem Quer Frear a IA
- O que está por trás do levante pela paralisação da IA encabeçado por executivos
- Novidade: Lançou o Fugu Ultra v2 e ele fez o DOBRO do Opus 5 num teste, será que vale?
Perguntas Frequentes (FAQ)
O que diferencia formalmente um Grafo de IA de uma cadeia tradicional em LangChain?
Uma cadeia linear tradicional (como a antiga LLMChain) opera como uma sequência unidirecional fixa: a saída de uma etapa é rigidamente a entrada da próxima, sem capacidade nativa de retorno ou avaliação de condições intermediárias. Já um Grafo de IA modela o sistema como uma máquina de estados finitos, permitindo loops, desvios condicionais com base em critérios lógicos e persistência contínua do estado ao longo de múltiplos ciclos de execução.
Por que o padrão Trabalhador-Supervisor é considerado superior a um prompt único complexo?
Quando exigimos que um modelo execute a geração, a análise crítica e a formatação em um único prompt longo (zero-shot ou few-shot), ele tende a apresentar perda de atenção no contexto (fenômeno do Lost in the Middle) e viés de confirmação sobre seus próprios erros. A divisão das atribuições em papéis independentes (um modelo focado apenas em produzir e outro voltado estritamente para auditar segundo critérios pré-fixados) viabiliza a detecção objetiva de falhas e a correção direcionada.
Como evitar que o ciclo entre Trabalhador e Supervisor gere custos descontrolados de tokens?
A salvaguarda fundamental consiste na implementação de travas de governança no estado compartilhado. Isso inclui definir um limite estrito de iterações máximas (como 3 a 5 ciclos), estabelecer pontuações mínimas de parada e configurar timeouts globais de execução. Se o limite for atingido sem aprovação do Supervisor, o sistema deve interromper a execução e emitir um alerta para validação humana, impedindo consumo ocioso da API.
Qual é a diferença entre Grafos Acíclicos Direcionados (DAGs) e os Grafos Cíclicos de IA?
DAGs, amplamente usados em orquestradores como Apache Airflow e Prefect, proíbem expressamente ciclos fechados para garantir que uma tarefa nunca retorne a um estágio anterior. Os Grafos de IA, por sua vez, abraçam a ciclicidade: a capacidade de retornar deliberadamente a um nó anterior com base no feedback é a chave para o refinamento adaptativo, algo inviável em uma estrutura estritamente acíclica.
É viável integrar intervenção humana (Human-in-the-Loop) em um Grafo de IA?
Sim, essa é uma das maiores vantagens operacionais dos grafos de estado. Com o uso de persistência e checkpoints, o grafo pode ser pausado exatamente após a execução do nó Trabalhador ou do Supervisor. O estado é retido no banco de dados e notifica um operador humano via interface web ou API. Somente após a aprovação ou inserção de notas adicionais pelo humano, o grafo retoma a execução para os nós subsequentes.
É necessário utilizar modelos de ponta (como GPT-4o ou Claude 3.5 Sonnet) em todos os nós do grafo?
Não. Uma das melhores práticas de otimização de custo consiste na especialização assimétrica dos nós. O nó Trabalhador pode operar com modelos mais econômicos e rápidos (como GPT-4o-mini ou Llama 3 8B), enquanto o Supervisor — encarregado da auditoria crítica e conformidade — utiliza um modelo de raciocínio mais robusto para inspecionar e guiar o processo, equilibrando eficiência financeira e precisão técnica.
Artigo redigido e expandido por Rodrigo Batista para o portal IA na Prática Digital, com base nas demonstrações práticas do canal Maestros da IA.
Quer dominar as ferramentas e automações mais avançadas?
Acompanhe o portal IA na Prática Digital para receber em primeira mão novos comparativos, testes reais de engenharia de prompt e fluxos de automação prontos para implementar no seu negócio.