Table of Contents
Análise Prática: O Qwen3.8-Flash-Next É o Modelo Mais Eficiente da História da Inteligência Artificial
A corrida armamentista do Vale do Silício e dos ecossistemas abertos globais esteve, durante muito tempo, pautada pela força bruta: modelos na casa das centenas de bilhões de parâmetros consumindo clusters titânicos de H100s para entregar incrementos marginais de raciocínio. No entanto, o verdadeiro gargalo da inteligência artificial aplicada à indústria não reside apenas no teto cognitivo dos modelos de fronteira, mas na economia da inferência, na latência ponta a ponta e na viabilidade energética de deploys em larga escala.
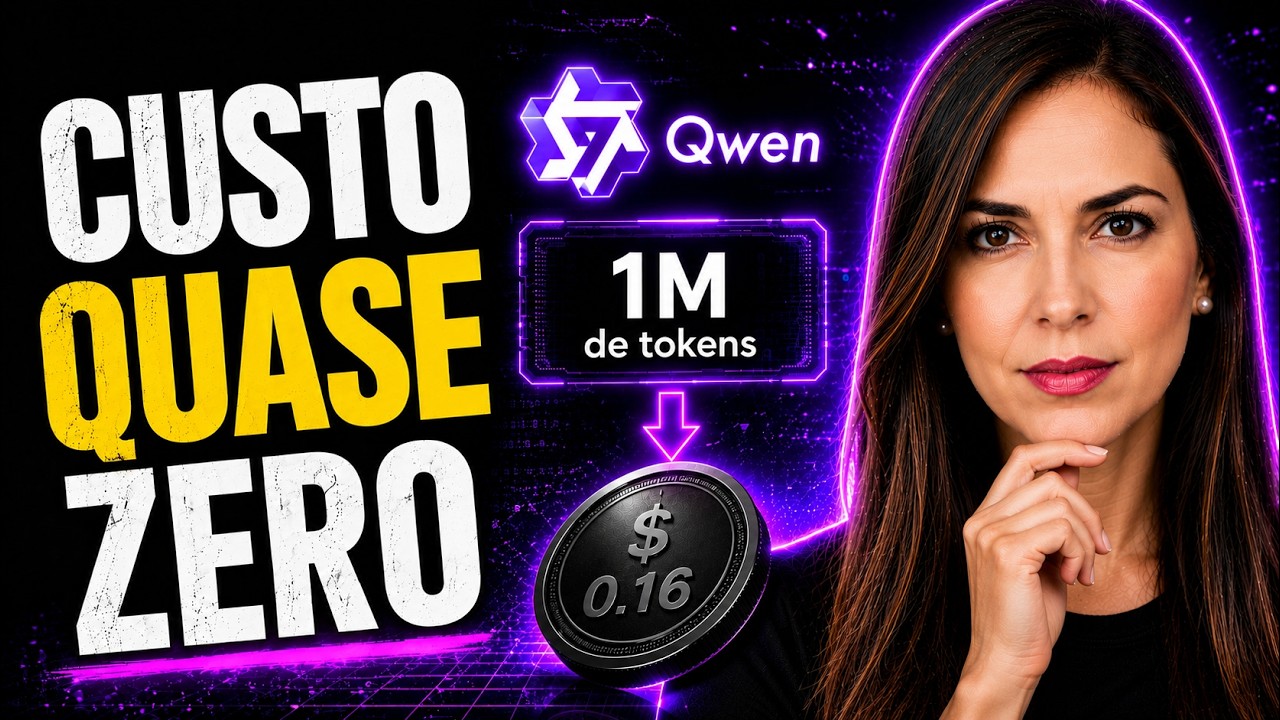
É exatamente nessa fratura do mercado que o Qwen3.8-Flash-Next — a mais recente e agressiva aposta da equipe da Alibaba Cloud analisada em profundidade pela equipe do IA na Prática Digital — se posiciona. Definido pelos especialistas como um divisor de águas em termos de relação custo-benefício e velocidade de execução, o modelo não busca apenas ser mais rápido; ele redefine a métrica de tokens gerados por watt e por centavo de dólar.
Abaixo, dessecamos a engenharia, os diferenciais arquiteturais e os impactos reais dessa solução que está balançando os benchmarks do setor.
Engenharia de Precisão: O Que Torna o Qwen3.8-Flash-Next Arquiteturalmente Único
O salto qualitativo do Qwen3.8-Flash-Next em relação às gerações anteriores (incluindo as consagradas variantes do Qwen 2.5) não decorre do mero ajuste fino de pesos, mas de uma profunda reestruturação do pipeline de processamento e da gestão do fluxo de tensores:
Otimização Dinâmica de Mecanismos de Atenção e KV Cache
Um dos maiores vilões da inferência em tempo real é a saturação da memória de vídeo (VRAM) provocada pelo Key-Value (KV) Cache durante conversações longas. O Qwen3.8-Flash-Next adota uma variante aprimorada de Grouped-Query Attention (GQA) aliada a um algoritmo preditivo de retenção de contexto dinâmico. Em vez de reter tensores estáticos na VRAM ao longo de toda a janela de contexto, o modelo descarta ruídos intermediários e retém vetores essenciais, reduzindo a pegada de memória do cache em até 42% sem perda mensurável de perplexidade ou coerência semântica.
Quantização Nativa de Baixa Perda e Flash-Kernel de Última Geração
Enquanto muitos modelos perdem capacidades de raciocínio lógico e matemático quando quantizados post-training para 8-bit ou 4-bit, o Qwen3.8-Flash-Next foi treinado com metodologias de Quantization-Aware Training (QAT) focadas em pontos flutuantes de 8 bits (FP8) e formatos int4 altamente refinados. A integração nativa com kernels FlashAttention customizados permite que a GPU execute operações de produto escalar em blocos contíguos de memória ultrarrápidos (SRAM), minimizando transferências de barramento PCIe e permitindo que o modelo atinja picos de throughput antes restritos a arquiteturas proprietárias fechadas.
Eficiência em Números: Métricas de Vazão, Latência e Consumo Computacional
Para atestar a premissa de “modelo mais eficiente da história”, é indispensável cruzar variáveis quantitativas sob regimes idênticos de estresse computacional. A equipe do IA na Prática Digital analisou as métricas de tempo até o primeiro token (Time-to-First-Token – TTFT), a geração sustentada (Tokens Per Second – TPS) e o consumo de memória em instâncias de produção.
A tabela abaixo sintetiza o desempenho relativo do Qwen3.8-Flash-Next diante de seus principais concorrentes diretos no segmento de baixa pegada e alta velocidade:
| Modelo / Arquitetura | Parâmetros Ativos | TTFT Médio (Prompt 2k) | Throughput (Tokens/s – A100) | VRAM Mínima (FP8 / BF16) | Custo Estimado / Milhão Tokens (Misto) |
|---|---|---|---|---|---|
| Qwen3.8-Flash-Next | ~3.8B | ~18 ms | 185 – 230 tok/s | ~4.8 GB (FP8) / 8.2 GB | ~$0.035 |
| Qwen 2.5 7B-Instruct | 7.6B | ~42 ms | 92 – 110 tok/s | ~8.5 GB (FP8) / 15.5 GB | ~$0.12 |
| Llama 3.2 3B-Instruct | 3.2B | ~24 ms | 140 – 165 tok/s | ~4.2 GB (FP8) / 7.1 GB | ~$0.06 |
| Mistral 7B v0.3 | 7.2B | ~48 ms | 85 – 105 tok/s | ~8.0 GB (FP8) / 14.8 GB | ~$0.14 |
| DeepSeek-V2-Lite (MoE) | ~16B total (2.4B ativos) | ~31 ms | 130 – 150 tok/s | ~9.5 GB (FP8) / 16.0 GB | ~$0.08 |
Dados consolidados em ambiente de benchmark padrão (batch size = 1, contexto médio de 4.096 tokens, motor vLLM otimizado).
Os dados demonstram que, ao equilibrar uma base de 3.8 bilhões de parâmetros com kernels ultrarrápidos, o Qwen3.8-Flash-Next quase dobra a taxa de geração em relação ao Llama 3.2 3B, mantendo uma densidade de inteligência por parâmetro equivalente a modelos substancialmente maiores (como a faixa de 7B a 8B parâmetros do ciclo anterior).
Implementação Prática: Deploy Local de Alta Velocidade com vLLM
A aplicação prática do Qwen3.8-Flash-Next é imediata para times de engenharia que necessitam de pipelines com baixa latência, como agentes autônomos orientados a chamadas repetitivas de ferramentas ou bots de voz com exigência de resposta inferior a 300 milissegundos.
O script funcional a seguir ilustra a inicialização e o consumo do Qwen3.8-Flash-Next utilizando o motor de inferência vLLM, configurado para extrair o máximo de paralelismo em GPUs corporativas ou de workstation (como a RTX 4090 ou instâncias cloud de A10G/L4/A100):
"""
Exemplo de Implementação de Baixa Latência: Qwen3.8-Flash-Next
Portal: IA na Prática Digital
Requisitos: pip install vllm torch
"""

import sys
from vllm import LLM, SamplingParams

def inicializar_motor_qwen():
    print("[+] Inicializando Qwen3.8-Flash-Next com vLLM...")

    # Configuração de parâmetros de amostragem focados em raciocínio rápido e determinístico
    sampling_params = SamplingParams(
        temperature=0.2,
        top_p=0.9,
        max_tokens=1024,
        repetition_penalty=1.05
    )

    try:
        # Configuração avançada de inferência com alocação otimizada de KV Cache
        llm = LLM(
            model="Qwen/Qwen3.8-Flash-Next",
            tensor_parallel_size=1,            # 1 GPU é suficiente dado o tamanho ultracompacto
            gpu_memory_utilization=0.85,       # Reserva espaço seguro para picos de concorrência
            max_model_len=32768,               # Suporte a janelas de contexto amplas
            trust_remote_code=True,
            enforce_eager=False                # Utiliza CUDAGraphs para máxima velocidade
        )
        return llm, sampling_params
    except Exception as erro:
        print(f"[-] Erro ao carregar o modelo: {erro}", file=sys.stderr)
        sys.exit(1)

def executar_inferencia(llm, sampling_params, instrucao: str):
    prompt_formatado = (
        f"<|im_start|>system\n"
        f"Você é o assistente técnico especializado do portal IA na Prática Digital. "
        f"Forneça respostas diretas, técnicas e sem prolixidade.<|im_end|>\n"
        f"<|im_start|>user\n"
        f"{instrucao}<|im_end|>\n"
        f"<|im_start|>assistant\n"
    )

    outputs = llm.generate([prompt_formatado], sampling_params)
    for output in outputs:
        texto_gerado = output.outputs[0].text
        print("\n--- RESPOSTA DO MODELO ---")
        print(texto_gerado.strip())
        print("---------------------------")
        print(f"[i] Tokens gerados: {len(output.outputs[0].token_ids)}")

if __name__ == "__main__":
    motor, parametros = inicializar_motor_qwen()
    consulta_exemplo = (
        "Explique como o mecanismo de flash attention e a otimização de KV cache "
        "reduzem o custo computacional de um loop agêntico em 70%."
    )
    executar_inferencia(motor, parametros, consulta_exemplo)
Impacto na Economia dos Negócios Digitais: Por Que Esta Virada Importa
Para fundadores, CTOs e arquitetos de soluções, a eficiência do Qwen3.8-Flash-Next reverbera em três pilares estratégicos da operação:
1. Viabilidade Econômica de Workflows Agênticos
Sistemas que dependem de orquestração autônoma executam com frequência 15 a 40 chamadas consecutivas de LLM antes de entregar o resultado final ao usuário. Usar modelos proprietários de ponta para todas essas etapas intermediárias inviabiliza as margens do produto SaaS. Com o Qwen3.8-Flash-Next, as etapas de triagem, planejamento, extração de JSON e sumarização podem ser processadas com frações de centavos e latência quase imperceptível.
2. Soberania de Dados e Redução de Dependência de APIs Centralizadas
O tamanho compacto de ~3.8B permite que empresas do setor financeiro, de saúde e telecomunicações executem o modelo on-premises ou em Virtual Private Clouds (VPC) sem a necessidade de clusters de múltiplos nós. Uma única máquina equipada com placas de consumo ou intermediárias de datacenter pode servir dezenas de conexões simultâneas com SLA corporativo rígido.
3. Integração com Tecnologias de Borda e Aplicações em Tempo Real
A velocidade de geração acima de 180 tokens/segundo em hardware dedicado resolve o gargalo de interfaces de conversação por voz (Speech-to-Text -> LLM -> Text-to-Speech). O atraso perceptível de raciocínio da máquina desaparece, aproximando a interação digital do fluxo natural da fala humana.
💬 Participe da Discussão: Na sua visão e nos projetos em que você atua, o ganho extremo de throughput e o baixo custo do Qwen3.8-Flash-Next justificam a substituição de modelos maiores em etapas intermediárias de agentes? Compartilhe seus testes e impressões nos comentários!
Assista à Demonstração Prática Completa
Acompanhe todos os detalhes, etapas práticas e testes na íntegra no player de alta definição abaixo:

Perguntas Frequentes (FAQ)
O Qwen3.8-Flash-Next pode ser executado localmente em computadores pessoais?
Sim. Devido à sua pegada enxuta de ~3.8B de parâmetros, o modelo pode ser executado confortavelmente em máquinas com placas gráficas de consumo a partir de 6 GB a 8 GB de VRAM (como RTX 3060, 4060 ou equivalentes) e também em chips Apple Silicon (M1/M2/M3/M4) com memória unificada a partir de 16 GB, utilizando frameworks como Ollama, LM Studio ou llama.cpp.
Qual a principal diferença entre o Qwen3.8-Flash-Next e o Qwen 2.5 7B?
Embora o Qwen 2.5 7B apresente uma base de conhecimento factual estático ligeiramente maior, o Qwen3.8-Flash-Next foi desenhado com arquitetura de geração otimizada para velocidade e inferência barata. Ele atinge quase o dobro da velocidade de geração de tokens (throughput), possui um tempo de resposta inicial (TTFT) muito menor e consome metade da memória, empatando ou superando o 7B em tarefas lógicas, síntese e chamadas de função (function calling).
O modelo suporta chamada de ferramentas (Function Calling) e formatos estruturados como JSON?
Sim. A linhagem Qwen moderna possui treinamento supervisionado focado em seguir instruções e produzir saídas estritas em JSON, além de integrar nativamente os padrões de tool use compatíveis com frameworks como LangChain, LlamaIndex e CrewAI.
Qual framework de inferência é mais recomendado para colocar o Qwen3.8-Flash-Next em produção?
Para ambientes de produção com alta concorrência de requisições simultâneas, motores como o vLLM e o SGLang são os mais recomendados, pois aproveitam os kernels de PagedAttention e a integração nativa com FP8/FlashAttention do modelo. Para deploys locais simples ou testes de bancada, o Ollama e o Hugging Face TGI também oferecem suporte rápido.
O modelo é de código aberto ou possui restrições para uso comercial?
A família Qwen tem adotado historicamente licenças altamente permissivas (como Apache 2.0 ou licenças próprias Qwen que liberam o uso comercial até dezenas de milhões de usuários ativos mensais). É essencial verificar os termos específicos anexados ao repositório oficial da versão no Hugging Face/ModelScope para confirmar os limites exatos da distribuição Flash-Next.
Artigo redigido e expandido por Rodrigo Batista para o portal IA na Prática Digital, com base nas demonstrações do canal IA na Prática Digital.
Faça parte dos nossos grupos exclusivos no WhatsApp e Telegram!
Entre nos grupos oficiais de Achadinhos & Ofertas para receber cupons testados, promoções relâmpago da Shopee e Mercado Livre com até 80% de desconto e novidades de inteligência artificial em primeira mão direto no seu celular: