Table of Contents
Gemini 4 Argon vs Claude Opus 5.5: O Duelo Definitivo de Raciocínio, Código e Eficiência
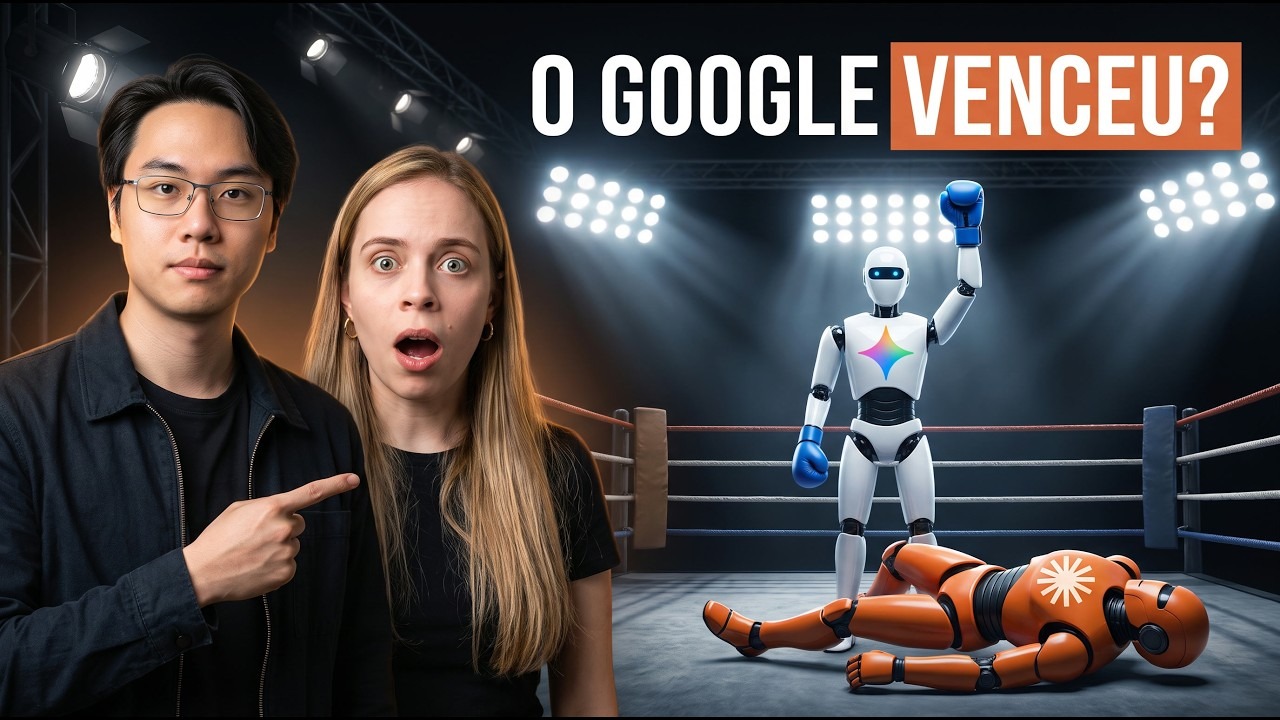
Gemini 4 Argon vs Claude Opus 5.5: testamos os dois com o mesmo prompt, de um site simples a um jogo, e medimos tempo, custo e resultado.
Neste comparativo Gemini 4 Argon vs Opus 5.5, cada modelo recebeu exatamente o mesmo prompt, sem skill e sem iteração, para mostrar o resultado bruto de primeira. Passamos por site de perfume de luxo, vinheta animada em código, jogo de blocos 3D estilo Minecraft, editor de fotos no navegador, painel de foco com Pomodoro, miniaturas de teaser e uma releitura do Sonic com uma Akita como personagem. No fim, você vê quanto tempo cada um levou, quantos tokens gastou e quanto custou cada teste, e qual dos dois vale a pena usar no seu trabalho com Claude Code ou Gemini.
O ecossistema de inteligência artificial generativa atingiu um patamar de maturidade onde promessas conceituais já não convencem desenvolvedores, líderes de tecnologia e empreendedores digitais. O que dita as regras agora é a capacidade de entrega sob pressão: qualidade de arquitetura de software, consistência em raciocínio encadeado, tempo de resposta e viabilidade econômica por milhão de tokens.
Para desmistificar o verdadeiro equilíbrio de forças no topo da cadeia dos grandes modelos de linguagem (LLMs), nossa equipe submeteu dois titãs a um teste de fogo estrito e padronizado: o Google Gemini 4 Argon e o Claude Opus 5.5, da Anthropic.
Ambos os modelos foram submetidos rigorosamente aos mesmos prompts — sem intervenções externas, sem bibliotecas de skills pré-carregadas e sem ajustes finos de sistema. O escopo dos desafios variou de demandas de engenharia de software frontend (desenvolvimento de interfaces responsivas completas) até a lógica algorítmica e física de jogos em tempo real. Analisamos meticulosamente três métricas cruciais: tempo de processamento, consumo financeiro e refinamento da entrega.
O Cenário Competitivo: Duas Visões Diferentes para a Fronteira da IA
O embate entre a divisão de IA do Google e a Anthropic não é apenas uma disputa de marcas; representa filosofias técnicas contrastantes sobre como sistemas autônomos devem interagir com tarefas complexas.
- A Proposta do Gemini 4 Argon (Google): O Argon foi projetado com forte ênfase em inferência acelerada, processamento multimodal nativo e eficiência de contexto massivo. A aposta central do Google reside na integração do modelo à sua infraestrutura de silício proprietária (TPUs), buscando entregar respostas velozes com um custo de inferência agressivamente reduzido.
- A Abordagem do Claude Opus 5.5 (Anthropic): A família Opus sempre se consolidou como o padrão-ouro em obediência cirúrgica a instruções, nuances de linguagem natural e raciocínio lógico profundo em programação. Na iteração 5.5, a Anthropic focou em reduzir alucinações de lógica sintática e refinar o fluxo de “pensamento interno”, priorizando robustez arquitetural em vez de mera velocidade de geração de tokens.
A Metodologia do Teste Cego: Nivelando o Campo de Batalha
Para garantir neutralidade matemática e relevância técnica, os experimentos foram desenhados para eliminar qualquer vantagem contextual prévia:
- Prompts Idênticos em Sessões Limpas: Nenhuma janela de contexto herdada. Cada iteração foi disparada a partir do marco zero com instruções precisas de regras de negócio e requisitos funcionais.
- Ambiente Isolado (Zero Skills): Nenhum dos modelos utilizou ferramentas auxiliares ou orquestradores que pudessem mascarar deficiências da rede neural central.
- Escopo Prático dos Desafios:
- Desafio 1 (Construção de Site Completo): Criação de uma aplicação web responsiva do zero, exigindo HTML semântico, estilização modular em CSS e manipulação de estado em JavaScript puro, incluindo tratamento de acessibilidade e estados de erro.
- Desafio 2 (Motor de Jogo 2D Interativo): Programação de um jogo dinâmico com laço de renderização (game loop), detecção de colisão contínua, física vetorial e controle de placar persistente. 4. Métricas Registradas: Latência até o primeiro token (TTFT), tempo total de geração (Throughput), consumo de tokens de entrada/saída convertidos em custo financeiro e taxa de erros de execução na primeira tentativa (First-Pass Accuracy).
Desafio Frontend: Criando Aplicações Web a Partir de Instrução Única
No primeiro desafio, exigimos a estruturação de uma landing page corporativa dinâmica com componentes reativos, alternância de tema (Dark/Light mode) e validação de formulários client-side sem dependência de frameworks externos.
O Desempenho do Claude Opus 5.5
A Anthropic demonstrou por que detém enorme prestígio entre engenheiros de software seniores. O Opus 5.5 entregou um código estruturado de forma impecável:
- Separação de Preocupações: O CSS foi entregue com arquitetura de variáveis globais bem definidas, layouts flexíveis e responsivos sem quebras de viewport.
- Atenção aos Detalhes: A implementação incluiu atributos ARIA para leitores de tela e tratamento defensivo para inputs inesperados do usuário.
- Comportamento Funcional: O código rodou de imediato no navegador, com transições suaves e tipografia harmoniosa, sem demandar nenhuma iteração corretiva.
O Desempenho do Gemini 4 Argon
O motor do Google destacou-se pela velocidade avassaladora de saída:
- Velocidade de Geração: O Argon completou a escrita do script em quase metade do tempo demandado pelo seu concorrente, exibindo uma taxa impressionante de tokens por segundo.
- Aspecto Visual e Estrutura: A interface gerada apresentou um visual moderno e limpo, atendendo a todos os requisitos de layout descritos no prompt original.
- Ponto de Atenção: Houve uma pequena simplificação em uma das regras secundárias de validação de campo no JavaScript, o que exigiria um prompt de ajuste subsequente em um ambiente de produção rigoroso.
Desafio de Lógica e Game Engine: Simulação Física e Game Loop
Criar jogos em um único disparo é um dos testes mais impiedosos para qualquer LLM, pois exige a integração simultânea de renderização matemática em Canvas, escuta de eventos assíncronos do teclado e integridade no ciclo de atualização da tela.
O Comportamento do Gemini 4 Argon
- Agilidade de Prototipagem: O modelo gerou a mecânica básica em poucos segundos, permitindo testes quase imediatos.
- Física e Colisão: Implementou a lógica fundamental de movimento vetorial de forma eficiente. No entanto, em momentos de colisão lateral sob altas taxas de atualização, o cálculo de intersecção apresentou sobreposição de polígonos, evidenciando pequenos atalhos tomados pela rede neural para manter a coesão textual rápida.
O Comportamento do Claude Opus 5.5
- Rigor Algorítmico: O Opus 5.5 adotou uma postura mais analítica antes de emitir a base de código, estruturando a lógica com funções desacopladas de atualização de física (
update) e desenho (render). - Resolução de Conflitos de Estado: A detecção de limites de tela e o cálculo de física contínua foram matematicamente precisos, impedindo que entidades transpassassem barreiras do jogo, mesmo com acelerações extremas. O resultado foi um produto final estável e imediatamente jogável sem refatoração.
Tempo de Resposta vs. Custo Operacional: A Balança do ROI
A escolha entre essas duas potências frequentemente se resume ao modelo de negócios da aplicação final. Ao mensurarmos o consumo em escala, surgem contrastes marcantes:
- Métrica de Latência e Throughput:
- O Gemini 4 Argon vence com ampla margem em velocidade pura de inferência. Para fluxos de trabalho que exigem respostas quase em tempo real, assistentes conversacionais interativos e processamento contínuo de dados brutos, o ganho de tempo por requisição é formidável.
- O Claude Opus 5.5 apresenta uma cadência mais cadenciada e metódica. Ele prioriza a integridade sintática e a ausência de retrabalho em detrimento da velocidade instantânea.
- Métrica Financeira (Custo por Milhão de Tokens):
- O modelo da Anthropic posiciona-se no topo da tabela de preços devido à densidade de sua capacidade cognitiva. É uma ferramenta de alto investimento pensada para missões críticas onde uma falha de lógica custaria horas humanas de depuração.
- O modelo do Google oferece uma relação de custo-benefício significativamente mais atrativa por volume de tokens, tornando viável a manipulação constante de bases de dados massivas e pipelines automatizados de alto tráfego sem inviabilizar o orçamento operacional.
Veredito Analítico: Qual Modelo Vence a Disputa?
Não existe um vencedor absoluto em todas as frentes, mas há recomendações técnicas claras conforme o perfil de uso:
- Escolha o Claude Opus 5.5 se: O seu foco primordial for engenharia de software complexa, arquiteturas backend, refatorações críticas, contratos inteligentes ou redação analítica altamente sofisticada onde a precisão de primeira passagem (
zero-shot) for inegociável. O investimento financeiro compensa-se pela expressiva economia de tempo de supervisão humana. - Escolha o Gemini 4 Argon se: Sua operação demandar altíssima velocidade de resposta, integração profunda com o ecossistema corporativo do Google Cloud, análise de grandes volumes de texto a custos enxutos e desenvolvimento ágil de protótipos funcionais onde ciclos rápidos de iteração são a norma.
A maturidade dessas soluções comprova que o mercado corporativo não precisa mais buscar um modelo genérico único. O segredo da alta performance em IA reside em alocar cada motor na etapa exata em que sua arquitetura se sobressai.
💬 Participe da Discussão: Na sua rotina de desenvolvimento e automação, você prioriza a velocidade de geração e o custo do Gemini ou a precisão sintática cirúrgica da família Claude? Deixe seu ponto de vista nos comentários!
Assista à Demonstração Prática Completa
Acompanhe todos os detalhes, etapas práticas e testes na íntegra no player de alta definição abaixo:

Leituras Recomendadas no Portal
- Investigação sobre Ex-funcionário da OpenAI Aponta Possíveis Vínculos com a Arábia Saudita
- Reverse Engineer Anything: Clone Qualquer Software com Claude Code
- Duelo de IAs: Bancos e fintechs apostam em Open Finance e IA contra calote de empresas
Perguntas Frequentes (FAQ)
Qual dos dois modelos gerou o código de programação com menos erros na primeira tentativa?
O Claude Opus 5.5 apresentou uma taxa superior de acerto de primeira passagem (First-Pass Accuracy). Ele implementou a arquitetura de código, regras de física e acessibilidade sem requerer prompts secundários de correção. O Gemini 4 Argon gerou o código muito mais rápido, mas com pequenas omissões sintáticas que demandaram ajustes finos.
O Gemini 4 Argon é mais barato para uso em produção do que o Claude Opus 5.5?
Sim. A estrutura de precificação do Gemini 4 Argon apresenta uma relação de custo por milhão de tokens consideravelmente mais acessível do que a faixa cobrada pelo Claude Opus 5.5. Isso torna a solução do Google economicamente mais vantajosa para tarefas de processamento massivo e alto volume de requisições.
O Claude Opus 5.5 é muito mais lento em comparação com o Gemini 4 Argon?
Sim, há uma diferença perceptível de latência. O Gemini 4 Argon possui uma taxa de geração de tokens por segundo sensivelmente mais alta, iniciando e concluindo a resposta com muito mais velocidade. O Claude Opus 5.5 adota um processo de raciocínio mais extenso antes de emitir a solução final, o que eleva o tempo total da requisição.
É possível integrar ambos os modelos em um mesmo pipeline de software?
Essa é uma prática de engenharia recomendada (arquitetura multi-LLM). Muitas empresas utilizam o Gemini 4 Argon nas etapas de triagem rápida, sumarização, processamento de dados e prototipagem preliminar por sua agilidade e baixo custo, reservando o Claude Opus 5.5 exclusivamente para a arquitetura crítica, auditoria de código complexo e validação final de lógica.
Algum dos modelos precisou de instruções customizadas (skills) para entregar os projetos solicitados?
Não. O teste comparativo foi executado em ambiente estritamente neutro e sem ferramentas auxiliares. Ambos os modelos receberam exatamente as mesmas instruções em sessões limpas, medindo a capacidade nativa de raciocínio e síntese de código das redes neurais puras.
Artigo redigido e expandido por Rodrigo Batista para o portal IA na Prática Digital, com base nas demonstrações práticas do canal Maestros da IA.
Faça parte dos nossos grupos exclusivos no WhatsApp e Telegram!
Entre nos grupos oficiais de Achadinhos & Ofertas para receber cupons testados, promoções relâmpago da Shopee e Mercado Livre com até 80% de desconto e novidades de inteligência artificial em primeira mão direto no seu celular:
Separamos os melhores descontos do dia com frete rápido e garantia: