A Nova Linha de Fratura Digital: Como a IA Transformou a Privacidade Corporativa em um Artigo de Luxo
Segurança na IA: Gigantes como Nvidia e Palantir estão bloqueando o ChatGPT e o Claude por risco de vazamento. Descubra o que acontece com os seus dados no uso diário.
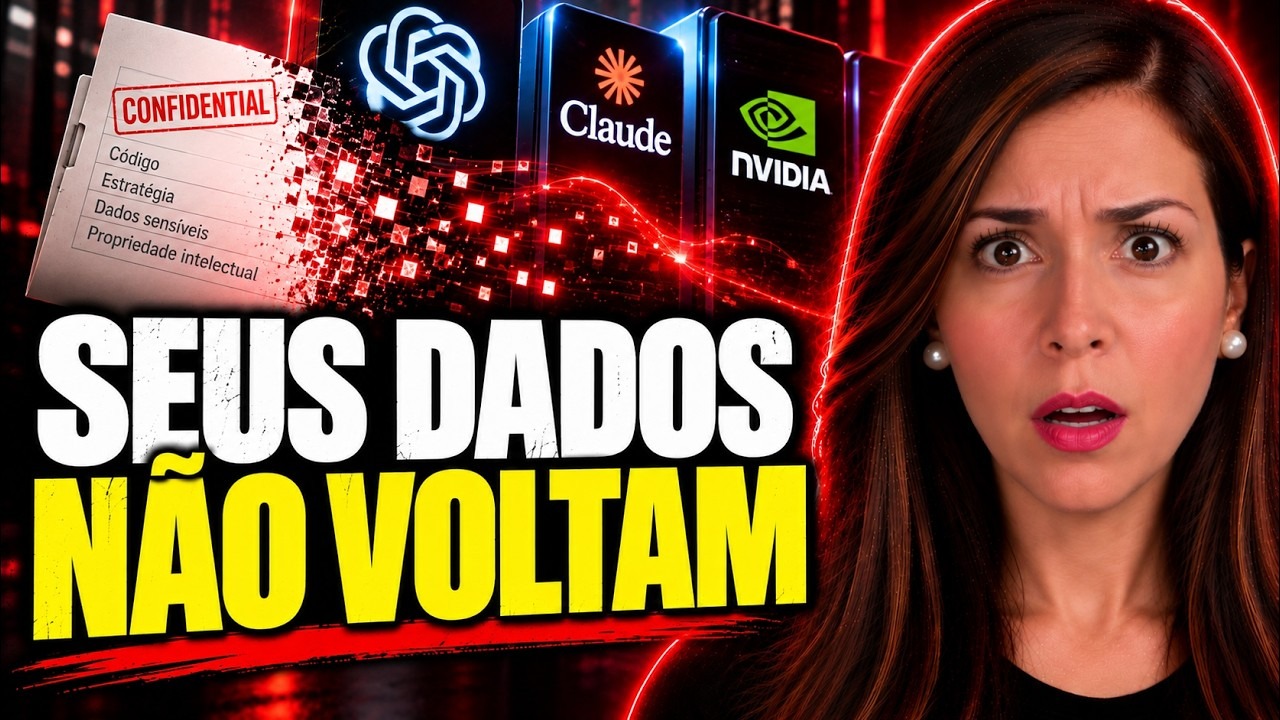
Recentemente, gigantes do mercado como Nvidia, Palantir e Samsung tomaram a decisão drástica de restringir ou proibir o uso de assistentes comerciais como o ChatGPT da OpenAI e o Claude da Anthropic. O motivo central é o receio com a retenção de logs e o vazamento de propriedade intelectual. Para evitar esse risco, muitas dessas corporações estão migrando para modelos próprios como o Nemotron ou soluções de código aberto como o Llama, garantindo servidores isolados.
📌 Principais Destaques da Demonstração:
- Vazamento de Dados: Entenda como o histórico de navegação e prompts podem ficar armazenados nos servidores.
- Privacidade no Trabalho: Descubra por que bancos e empresas de tecnologia proíbem o uso de IAs comerciais.
- Estratégias de Proteção: Aprenda a configurar suas contas para limitar a retenção de logs e manter o controle total do seu conteúdo.
A cena tornou-se corriqueira em escritórios de todo o mundo: diante de um prazo apertado, um analista copia uma planilha com projeções financeiras sensíveis e a despeja na caixa de texto do ChatGPT. Em outro setor, um desenvolvedor cola centenas de linhas de código proprietário no Claude para debugar uma falha crítica de software. Em segundos, o problema está resolvido. No entanto, por trás da aparente eficiência instantânea, consolida-se uma das transformações mais perigosas da era da informação: a criação de uma barreira invisível que divide as organizações entre aquelas com capital para comprar imunidade algorítmica e a esmagadora maioria que entrega segredos de negócio em troca de conveniência.
Enquanto corporações de vanguarda como Nvidia, Palantir e instituições de Wall Street impõem bloqueios severos ou restringem o acesso de seus times a interfaces públicas de inteligência artificial, o mercado tradicional segue operando sob uma perigosa ilusão de confidencialidade. A privacidade de dados deixou de ser um direito padrão da arquitetura de software para se tornar uma mercadoria corporativa restrita a planos de alto custo.
—
O Êxodo dos Gigantes: O Que Nvidia, Palantir e Wall Street Compreenderam Antes do Mercado
O bloqueio imposto por companhias do calibre da Nvidia e da Palantir ao uso indiscriminado de interfaces de IA como o ChatGPT e o Claude não decorre de aversão à tecnologia. Trata-se de uma manobra estritamente defensiva de salvaguarda de propriedade intelectual. Ambas as organizações operam no ápice do desenvolvimento tecnológico global — a primeira dominando o fornecimento de processadores neurais e designs de arquitetura de silício; a segunda gerindo plataformas de inteligência de dados que atendem desde setores de defesa governamentais até conglomerados aeroespaciais.
Para essas companhias, a presença de ferramentas de IA generativa operando em redes corporativas sem isolamento criptográfico integral representa o que especialistas chamam de Shadow AI (IA Invisível). O risco não se resume a um ataque hacker convencional, mas sim à contaminação de bases externas de dados. Quando um funcionário insere planos de chips, rotinas de criptografia ou análises de vulnerabilidades em uma plataforma comercial aberta, ele renuncia ao controle físico sobre a trajetória daquela informação.
Instituições financeiras como JPMorgan Chase, Citigroup e Goldman Sachs foram as primeiras a erguer barreiras contra o consumo livre dessas ferramentas ainda em 2023. O temor, agora compartilhado pelos gigantes do Vale do Silício, é duplo:
- Exposição direta de segredos industriais: O armazenamento de dados em servidores de terceiros sob regimes de retenção técnica que fogem ao controle dos times de compliance.
- Risco de extração adversarial e aprendizado não supervisionado: A possibilidade de que fragmentos de informações proprietárias sejam internalizados pelos pesos dos modelos em rodadas subsequentes de retreinamento, reaparecendo como resposta para concorrentes ou usuários externos.
—
A Anatomia do Envio: O Caminho Oculto dos Seus Dados Após o Clique
Muitos profissionais acreditam que a comunicação com um modelo de linguagem se encerra na entrega da resposta na tela. Trata-se de um equívoco arquitetural profundo. O tráfego de dados nas versões gratuitas e de entrada das principais plataformas de IA envolve múltiplos estágios de custódia e processamento:
- Trânsito e Ingestão: Os dados saem da máquina do usuário via protocolos web padrão e aterrissam nos clusters dos provedores de nuvem controlados pelas criadoras dos modelos (como OpenAI, Anthropic ou Google).
- Revisão de Segurança e Abuso (Safety Buffers): Mesmo quando o usuário desativa formalmente a opção de usar seus dados para treinamento do modelo nas configurações da conta, a maioria dos termos de serviço reserva o direito de reter os prompts e outputs por períodos de 30 a 90 dias. Esse intervalo serve para análise forense automatizada ou revisão humana contra violações de diretrizes éticas e legais.
- Acesso por Operadores Humanos: Amostras de conversas são periodicamente desidentificadas e encaminhadas para contratados externos com o objetivo de aprimorar o aprendizado por reforço com feedback humano (RLHF). Durante esse processo, dados sensíveis que não foram devidamente mascarados pelo usuário podem ser lidos diretamente por operadores terceirizados.
- Vetorização e Indexação: Quando ferramentas de busca ou de análise de arquivos são ativadas, os documentos anexados passam por processos de vetorização, sendo armazenados temporariamente em bancos de vetores que residem na nuvem do fornecedor, sujeitos a brechas de configuração ou ataques de injeção de comandos indiretos (prompt injection).
O usuário médio, ao assinar planos individuais padrão, assume um contrato de adesão no qual sua privacidade opera em um modelo permissivo. Em contraste, o tráfego corporativo sofisticado exige garantias contratuais de retenção zero de dados (Zero Data Retention – ZDR), chaves de criptografia sob custódia do cliente (Bring Your Own Key – BYOK) e instâncias computacionais isoladas (single-tenant).
—
A Divisão Invisível: A Assimetria entre o Consumo em Massa e o Refúgio Corporativo
O mercado de tecnologia gerou uma clivagem nítida: de um lado, usuários finais, profissionais liberais e pequenas empresas que financiam indiretamente o avanço dos modelos por meio de seus próprios dados operacionais; do outro, grandes corporações que pagam contratos milionários para operar em ambientes murados.
Essa dinâmica transforma a segurança em um divisor de águas competitivo. Organizações que operam com margens estreitas ou falta de letramento digital tendem a utilizar versões comuns de chatbots para criar contratos, avaliar balanços e debugar produtos. Já empresas estruturadas contam com contratos corporativos específicos, como o ChatGPT Enterprise ou o Claude for Work, que juridicamente renunciam a qualquer uso de dados para treinamento e oferecem trilhas de auditoria para SOC 2 Type II e ISO 27001.
A tabela a seguir evidencia os abismos técnicos, operacionais e de governança entre as diferentes abordagens de consumo de IA generativa disponíveis no mercado:
| Parâmetro de Governança | Nível Gratuito / Básico (Consumer) | Planos Pagos Individuais (Pro / Plus) | Soluções Corporativas (Enterprise / APIs) | Instâncias Locais / Self-Hosted (On-Premises) |
|---|---|---|---|---|
| Uso de Prompts para Treinamento | Habilitado por padrão; requer opt-out manual do usuário | Habilitado por padrão na maioria; opt-out manual nas configurações | Bloqueado contratualmente por padrão (sem treino) | Impossível (o modelo não se comunica com o provedor) |
| Período de Retenção de Dados | Geralmente 30 dias (mesmo com histórico desativado) | Geralmente 30 dias para moderação de abuso | Zero Data Retention (ZDR) configurável mediante contrato | Zero dias externos (controle total da infraestrutura interna) |
| Revisão Humana de Conteúdo | Sim, via amostragem de dados para auditoria e RLHF | Baixa probabilidade, mas prevista em termos de uso | Estritamente proibida por SLA contratual | Inexistente (dados restritos ao ambiente local) |
| Gerenciamento de Chaves de Criptografia (KMS) | Gerenciado inteiramente pelo provedor de IA | Gerenciado inteiramente pelo provedor de IA | Suporte a BYOK (Bring Your Own Key) e VPC peering | Controle 100% interno sob governança da própria empresa |
| Conformidade Regulatória (LGPD, GDPR, HIPAA) | Sem garantias contratuais ou BAA formal | Garantias genéricas de termos de uso de consumo | Acordos formais de tratamento de dados (DPA) e BAA | Conformidade desenhada pela arquitetura interna da empresa |
| Custo de Implementação e Manutenção | Gratuito | Médio (~US$ 20 a US$ 30 por usuário/mês) | Alto (Contratos corporativos mínimos anuais) | Elevado (Investimento intensivo em GPUs ou servidores) |
—
Estratégias de Defesa para Empresas Sem Orçamentos Milionários
A disparidade financeira não significa que profissionais autônomos e empresas de médio porte devam se resignar à vulnerabilidade. É plenamente viável erguer uma governança robusta de dados sem a necessidade de assinar contratos de seis dígitos:
- Higienização Ativa e Mascaramento Prévio de Prompts: Antes de submeter qualquer documento a uma IA externa, remova identificadores reais. Substitua nomes de clientes por codinomes (“Cliente Alfa”), converta valores monetários exatos em proporções percentuais e elimine chaves de API, e-mails e CPFs.
- Utilização de APIs com Políticas de Retenção Zero: O acesso a modelos via interface gráfica (o chat comercial no navegador) possui regras diferentes do consumo via API direta. Grandes fornecedores oferecem termos de não retenção de dados mais rigorosos em endpoints de API, mesmo para contas de menor porte, cobrando estritamente pelo volume de tokens consumidos.
- Implementação de Modelos de Pesos Abertos em Servidores Próprios: Modelos avançados de código aberto (como as famílias Llama e Mistral) podem ser executados localmente ou em nuvens privadas controladas pela própria empresa. Ferramentas de orquestração interna permitem que pequenas equipes processem documentos jurídicos e contábeis de extrema sensibilidade sem que um único byte saia do perímetro de segurança da empresa.
- *Criação de Diretrizes Claras de Acceptable Use Policy (AUP):* O maior vetor de vazamento de dados não é a falha criptográfica, mas o desconhecimento do operador. Estabeleça regras transparentes para sua equipe detalhando quais categorias de informação podem ser enviadas para IAs públicas e quais exigem tratamento estritamente manual ou isolado.
—
O Desafio da Autonomia: Da Conversa aos Agentes Independentes
À medida que o ecossistema de inteligência artificial transita do modelo de respostas baseadas em texto para o paradigma de agentes autônomos integrados a sistemas legados, o desafio da segurança de dados atinge outro patamar. Softwares inteligentes conectados a e-mails, bancos de dados relacionais e sistemas de gestão empresarial (ERPs) não apenas leem o que o usuário insere voluntariamente, mas interagem ativamente com fluxos de trabalho contínuos.
Nesse cenário, empresas que utilizam soluções sem garantias explícitas de soberania de dados correm o risco de expor ecossistemas inteiros de clientes e fornecedores. As decisões tomadas por corporações de elite, como Nvidia e Palantir, não representam um apego arcaico a métodos analógicos, mas sim a consciência de que a liderança na era da IA dependerá da capacidade de construir inteligência sem renunciar ao sigilo de seus ativos essenciais.
—
💬 Participe da Discussão: Como a sua empresa lida com o uso diário de ferramentas de IA? Vocês já possuem políticas claras de proteção de segredos de negócio ou a conveniência ainda fala mais alto na rotina de trabalho?
—
Assista à Demonstração Prática Completa
Acompanhe todos os detalhes, etapas práticas e testes na íntegra no player de alta definição abaixo:

Leituras Recomendadas no Portal
- Desabafo! Quase Troquei Meus Funcionários por IA (e por Que Eu Não Fiz Isso)
- Duelo de IAs: Juíza mantém processo contra OpenAI após venda de ações da Microsoft
- Criei Uma Rádio com Música do Mundo Inteiro Usando Só 1 Prompt no Gpt-6 Astra
Perguntas Frequentes (FAQ)
Por que grandes empresas de tecnologia proíbem funcionários de usar o ChatGPT comercial?
Empresas como Nvidia, Apple e grandes bancos de investimento bloqueiam o uso de interfaces públicas de IA porque os dados inseridos por colaboradores podem ser armazenados em servidores de terceiros, revisados por equipes humanas de moderação e potencialmente utilizados para atualizar ou treinar modelos futuros, expondo códigos-fonte internos, designs industriais e estratégias de negócios.
Desativar o histórico de conversas no ChatGPT impede que a OpenAI veja meus dados?
Desativar o histórico de chat impede que suas mensagens sejam utilizadas formalmente para treinar os modelos da empresa. No entanto, mesmo com o histórico desativado, os prompts e respostas ainda são retidos nos servidores por até 30 dias para monitoramento contra abusos e violações de segurança antes de serem permanentemente excluídos dos registros operacionais.
Qual é a diferença real entre usar a interface web comum e a API de um modelo de linguagem?
A interface web de consumo é desenhada para o usuário comum e seus termos padrão geralmente preveem o uso de dados para refinamento do serviço, salvo exceções ou opt-outs explícitos. Já o acesso via API é estruturado para desenvolvedores e empresas; os dados trafegados por API não são utilizados para treinar os modelos e contam com opções contratuais de Retenção Zero de Dados (Zero Data Retention).
É seguro colar planilhas com dados financeiros de clientes em ferramentas de inteligência artificial?
Não é seguro realizar essa operação em planos básicos ou gratuitos de chatbots comerciais abertos. Esses dados contêm Informações Pessoalmente Identificáveis (PII) e métricas confidenciais que, ao serem enviadas sem mascaramento prévio para servidores externos, podem violar legislações de proteção de dados (como a LGPD no Brasil) e comprometer os segredos de negócio da organização.
O que são modelos de pesos abertos e como eles garantem a soberania dos dados?
Modelos de pesos abertos (como as linhagens Llama e Mistral) são arquiteturas de IA cujos parâmetros neurais são distribuídos publicamente. Isso permite que uma empresa baixe o modelo e o execute dentro de seus próprios servidores ou data centers isolados (on-premises). Como a infraestrutura pertence à própria empresa, nenhum dado inserido no modelo é transmitido via internet para empresas terceiras.
O que as pequenas e médias empresas devem fazer para manter seus dados seguros sem altos orçamentos?
Pequenas e médias empresas devem implementar políticas claras de uso aceitável, treinar equipes para higienizar e anonimizar dados antes do envio de prompts, preferir o consumo via APIs corporativas com termos de retenção zero em vez de contas gratuitas de navegador, ou utilizar ferramentas locais de inferência para o processamento de materiais altamente confidenciais.
Artigo redigido e expandido por Rodrigo Batista para o portal IA na Prática Digital, com base nas demonstrações práticas do canal Paula Bernardes.
Quer dominar as ferramentas e automações mais avançadas?
Acompanhe o portal IA na Prática Digital para receber em primeira mão novos comparativos, testes reais de engenharia de prompt e fluxos de automação prontos para implementar no seu negócio.