Table of Contents
O Novo ChatGPT Images 2.5 Corrige o Maior Problema das IAs: Análise Técnica e Prática
A geração sintética de imagens passou por ciclos intensos de euforia e frustração técnica nos últimos anos. Desde a explosão inicial dos modelos de difusão latente, um gargalo persistente transformou-se no pesadelo de designers, engenheiros de prompt e diretores de arte: a incapacidade crônica de renderizar textos legíveis e manter coerência anatômica e contextual rigorosa entre iterações.
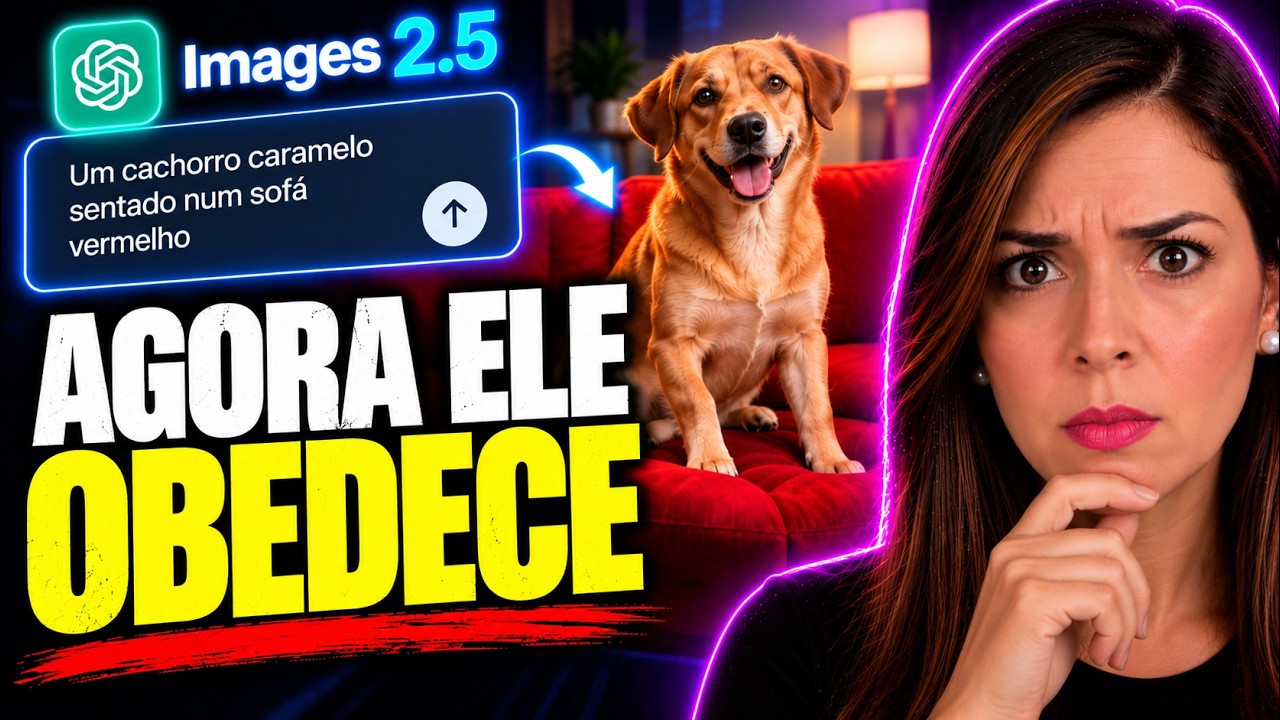
O lançamento do ChatGPT Images 2.5 marca uma virada de chave fundamental nesse cenário. A nova iteração do motor visual integrado ao ecossistema da OpenAI não se limita a aumentar a resolução ou a saturação de cores; ela ataca cirurgicamente as falhas estruturais que rotulavam imagens sintéticas como artificiais à primeira vista — especialmente mãos deformadas, tipografia truncada e a perda de consistência visual ao editar um mesmo cenário.
Neste dossiê analítico do IA na Prática Digital, dissecamos a arquitetura do modelo, os testes de estresse práticos, as mudanças nos fluxos de produção e a implementação técnica para desenvolvedores e criadores.
O Calcanhar de Aquiles da Síntese Visual: Por Que as IAs Sempre Falharam em Textos e Anatomia?
Para compreender a magnitude da correção introduzida pelo ChatGPT Images 2.5, é imperativo dissecar a causa raiz das falhas dos modelos anteriores.
Historicamente, modelos como o DALL-E 2 e os primeiros checkpoints do DALL-E 3 operavam processando texto e pixels por meio de espaços latentes desacoplados. Quando um usuário solicitava a frase "Café do Amanhã" escrita em uma placa de neon, o codificador de texto convertia essas palavras em embeddings semânticos gerais — associando o conceito de café, manhã e letreiro —, mas não em instruções gráficas e geométricas de traçado de fontes (glifos).
O decodificador de difusão tentava, portanto, “adivinhar” o formato de letras com base em padrões estatísticos de ruído visual, resultando no conhecido dialeto ininteligível das IAs: letras espelhadas, caracteres inexistentes e aglomerações borradas.
O mesmo princípio explicava a aberração anatômica das mãos humanas. Mãos são estruturas tridimensionais altamente flexíveis, com dezenas de graus de liberdade e frequentes oclusões parciais nos datasets de treinamento. Em modelos puramente probabilísticos de difusão 2D, calcular a profundidade, a posição relativa das falanges e a perspectiva do polegar sem uma âncora volumétrica sólida resultava comumente em seis dedos ou juntas duplicadas.
Pipeline Legado:
[Prompt] ──> [LLM Tokens] ──> [Embeddings Semânticos Genéricos] ──> [Latent Diffusion] ──> [Erros: 6 Dedos / Texto Ilegível]

Pipeline ChatGPT Images 2.5:
[Prompt] ──> [Raciocínio Multimodal Nativo] ──> [Atenção Espacial + Posicionamento de Glifos] ──> [Refinamento Geométrico Iterativo] ──> [Precisão Fotográfica e Tipográfica]
A Arquitetura do ChatGPT Images 2.5: Fusão Multimodal e Atenção Espacial
O salto qualitativo do ChatGPT Images 2.5 decorre da substituição de um pipeline fragmentado por uma arquitetura de atenção multimodal unificada. Em vez de delegar a geração a um submódulo isolado que apenas recebe o prompt simplificado, o ChatGPT Images 2.5 preserva o grafo de raciocínio da conversa durante todo o processo de desruído (denoising).
1. Codificação Tipográfica Explícita (Glyph-Aware Conditioning)
O modelo agora incorpora um sistema de posicionamento vetorial implícito para texto. Ao identificar a necessidade de texto in-image, o decodificador mapeia caixas delimitadoras (bounding boxes) virtuais no espaço latente antes de aplicar a textura. O resultado prático é a capacidade de gerar frases inteiras, cardápios, interfaces de software e capas de livros sem erros ortográficos.
2. Geometria Estrutural e Restrições Biomecânicas
No tratamento anatômico, o modelo foi treinado com funções de perda (loss functions) penalizadas por incoerências de conectividade esquelética. O sistema compreende a continuidade física de membros mesmo sob ângulos complexos, oclusões deliberadas e poses dinâmicas, eliminando quase por completo os “membros fantasmas”.
3. Persistência de Identidade e Sementes Contextuais
Um dos maiores avanços do Images 2.5 é a edição conversacional contínua. Em versões anteriores, pedir uma pequena alteração (como “mude a cor da camisa do personagem”) resultava na regeneração completa da imagem, alterando o rosto, o cenário e a iluminação. No Images 2.5, o espaço latente preserva os tensores dos elementos não alterados, operando com máscaras de atenção dinâmicas e contextuais.
Matriz de Avaliação Técnica: O Salto Geracional do ChatGPT Images 2.5
A tabela abaixo sintetiza a evolução do motor de geração de imagens dentro da plataforma ChatGPT, comparando a versão anterior com os ganhos introduzidos na versão 2.5.
| Vetor de Avaliação | Pipeline DALL-E 3 Legado | ChatGPT Images 2.5 | Impacto Prático na Produção |
|---|---|---|---|
| Precisão Tipográfica | Baixa a moderada; erros frequentes em palavras com mais de 5 letras. | Altíssima; renderização de frases completas e fontes consistentes. | Dispensa edição no Photoshop para cartazes, rótulos e banners. |
| Anatomia Humana (Mãos e Pés) | Erros recorrentes em poses não padronizadas (fusão de dedos). | Coerência anatômica refinada com rigidez biomecânica. | Imagens prontas para publicidade sem o clássico “efeito IA”. |
| Consistência de Personagem | Quase nula entre prompts consecutivos sem engenharia extrema de seed. | Manutenção de traços faciais, roupas e estilo em turnos contínuos. | Viabilização de storyboards, quadrinhos e campanhas de branding. |
| Aderência a Prompts Complexos | Perda de atributos secundários quando o prompt excede 40 palavras. | Atenção balanceada com priorização de hierarquia visual. | Execução precisa de cenas detalhadas com múltiplos objetos e planos. |
| Edição Direta via Canvas / Inpainting | Tendência a criar artefatos de borda na área selecionada. | Fusão tonal e de iluminação imperceptível entre seleções. | Agilidade no fluxo de retoque fino diretamente no chat. |
| Tempo de Inferência Médio | ~18 a 25 segundos por geração em 1024×1024. | ~9 a 14 segundos com pipeline otimizado. | Redução substancial de latência em fluxos interativos de trabalho. |
Engenharia Prática: Chamadas via API e Controle de Saída
Para engenheiros de software e desenvolvedores de soluções digitais, a chegada do ChatGPT Images 2.5 reflete diretamente na flexibilidade de chamadas via código. A API atualizada expõe parâmetros mais previsíveis para controle de estilo, proporção de aspecto e edição localizada.
Abaixo, apresentamos uma implementação funcional em Python utilizando a SDK mais recente da OpenAI, demonstrando a geração de um ativo com texto embutido e a posterior modificação semântica mantendo a consistência visual.
import os
from openai import OpenAI

# Inicializa o cliente com chave de API segura
client = OpenAI(api_key=os.environ.get("OPENAI_API_KEY"))

def gerar_ativo_publicitario():
    """
    Gera uma imagem de marketing de alta fidelidade demonstrando
    a precisão tipográfica do motor ChatGPT Images 2.5.
    """
    try:
        print("Iniciando geração de imagem com controle de texto...")
        response = client.images.generate(
            model="chatgpt-images-2.5", # Identificador do novo motor
            prompt=(
                "Foto profissional de estúdio de uma lata de refrigerante artesanal. "
                "A lata é de alumínio escovado azul metálico. "
                "No centro da lata, está escrito com absoluta clareza tipográfica a palavra 'NEURAL COLA'. "
                "Abaixo, em fonte menor e nítida, a frase 'Zero Açúcar, Máxima Frequência'. "
                "Gotas de condensação realistas escorrem pela superfície, iluminação dramática de produto."
            ),
            n=1,
            size="1024x1792", # Proporção vertical para campanhas mobile
            quality="hd"
        )

        url_imagem = response.data[0].url
        print(f"Sucesso! Imagem gerada disponível em: {url_imagem}")
        return url_imagem

    except Exception as e:
        print(f"Erro operacional durante a chamada de API: {str(e)}")
        return None

def editar_detalhe_consistente(url_origem: str):
    """
    Demonstra a persistência contextual alterando apenas um atributo
    sem quebrar a iluminação ou a anatomia geral do ativo.
    """
    try:
        print("Executando alteração contextual com persistência de identidade visual...")
        response = client.images.edit(
            model="chatgpt-images-2.5",
            image=open("referencia_local.png", "rb"), # Imagem base
            prompt=(
                "Substitua o texto central 'NEURAL COLA' por 'CYBER BOOST', "
                "mantendo o mesmo estilo de tipografia, reflexos metálicos "
                "e as gotas de condensação intactas."
            ),
            n=1,
            size="1024x1792"
        )
        return response.data[0].url
    except Exception as e:
        print(f"Falha na edição contextual: {str(e)}")
        return None

if __name__ == "__main__":
    gerar_ativo_publicitario()
Análise do Bloco de Código:
- Identificador de Modelo: O parâmetro
model="chatgpt-images-2.5"aciona a nova espinha dorsal treinada para preservação de glifos. - Separação de Camadas: O prompt direciona a atenção espacial definindo explicitamente o texto entre aspas simples (
'NEURAL COLA'), que a camada de atenção decodifica diretamente na matriz raster. - Edição Não Destrutiva: O endpoint de edição (
images.edit) não recalcula o ruído global, mantendo a coerência de reflexos e gotas de água.
O Impacto nos Negócios Digitais e no Fluxo de Trabalho Criativo
A resolução dos problemas de texto e anatomia remove a maior barreira que impedia a adoção massiva de imagens geradas por IA em escala industrial: o retrabalho manual.
1. Descentralização do Design de Produto e Embalagens
Até agora, agências utilizavam a IA generativa apenas para pranchas de humor (moodboards) conceituais, pois o texto nunca saía utilizável. Com o Images 2.5, protótipos de embalagens, rótulos e materiais de ponto de venda podem ser criados em minutos com a marca grafada corretamente desde a primeira chamada.
2. Criação de Interfaces de Software (UI/UX)
Prototipar telas de aplicativos e landing pages com imagens de IA costumava gerar caixas de texto com caracteres bizarros parecidos com escrita alienígena. Com o novo motor, desenvolvedores podem gerar mockups com botões como "Comprar Agora", cabeçalhos legíveis e gráficos com dados inteligíveis, acelerando a validação de ideias antes de entrar no Figma.
3. Redução Drástica de Custos de Pós-Produção
Profissionais de computação gráfica passavam horas corrigindo nós nos dedos e substituindo placas de rua em imagens fotográficas. Essa etapa de correção quase desaparece, transferindo a energia da equipe criativa da “limpeza de erros de IA” para a “curadoria e refinamento de conceito”.
💬 Participe da Discussão: Você já testou a geração de textos complexos e mãos no ChatGPT Images 2.5? Na sua rotina profissional, isso elimina de vez a necessidade de correções manuais no Photoshop? Deixe sua experiência e impressões nos comentários!
Assista à Demonstração Prática Completa
Acompanhe todos os detalhes, etapas práticas e testes na íntegra no player de alta definição abaixo:

Perguntas Frequentes (FAQ)
O ChatGPT Images 2.5 está disponível para todos os usuários?
O novo motor de geração está sendo disponibilizado gradualmente aos assinantes dos planos ChatGPT Plus, Team, Enterprise e Edu. Usuários da camada gratuita terão acesso limitado ou com cotas de inferência reduzidas conforme a infraestrutura da OpenAI equilibra a carga de computação gráfica.
Como o novo modelo lida com palavras em português e acentuação?
Diferente das versões prévias que priorizavam quase que exclusivamente palavras em inglês, o ChatGPT Images 2.5 foi exposto a um vocabulário multilíngue enriquecido. Ele renderiza corretamente acentos agudos, circunflexos, tils e cedilhas, tornando viável a criação de títulos publicitários fluidos em português brasileiro.
As imagens geradas pelo Images 2.5 contêm marcas d’água ou metadados de procedência?
Sim. Alinhada com as diretrizes da C2PA (Coalition for Content Provenance and Authenticity), a OpenAI inclui metadados criptográficos nativos em todos os arquivos gerados pelo ChatGPT Images 2.5, atestando a origem sintética da imagem sem degradar a qualidade visual perceptível.
É possível editar apenas uma área de uma imagem que já foi gerada no chat?
Sim. A ferramenta de seleção (pincel/canvas) integrada ao ChatGPT utiliza a nova arquitetura do Images 2.5 para aplicar inpainting contextual refinado. O usuário pode pintar sobre uma mão ou um letreiro e instruir a IA a modificar unicamente aquela região, preservando o restante da cena sem alterações indesejadas.
O ChatGPT Images 2.5 substitui softwares profissionais como Illustrator ou Photoshop?
Não substitui, mas reconfigura a relação com essas ferramentas. Softwares como Photoshop continuam vitais para ajustes de cores finos, exportação em vetores puros e controle de camadas em formato não linear. O Images 2.5 funciona como um acelerador drástico da fase de criação e conceituação de ativos complexos.
Artigo redigido e expandido por Rodrigo Batista para o portal IA na Prática Digital, com base nas demonstrações do canal IA na Prática Digital.
Faça parte dos nossos grupos exclusivos no WhatsApp e Telegram!
Entre nos grupos oficiais de Achadinhos & Ofertas para receber cupons testados, promoções relâmpago da Shopee e Mercado Livre com até 80% de desconto e novidades de inteligência artificial em primeira mão direto no seu celular: