Table of Contents
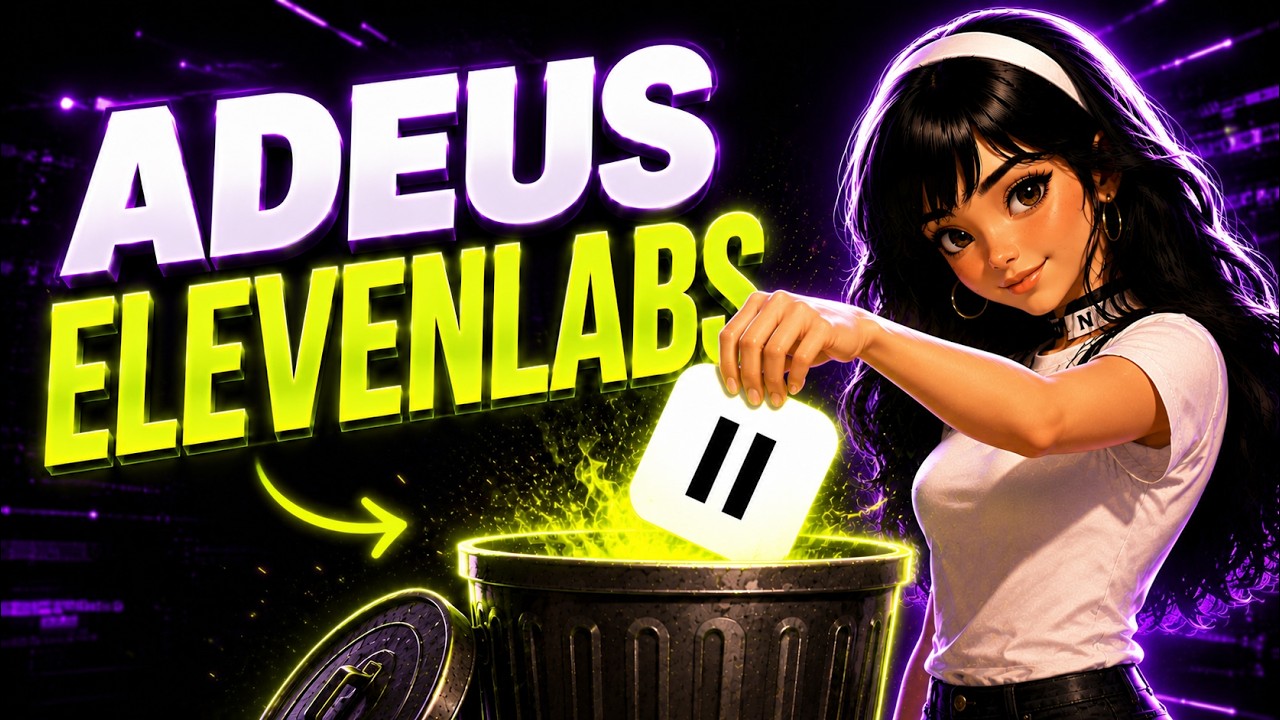
O Fim das Mensalidades Caras em Síntese de Voz: Como Ferramentas Gratuitas e de Pesos Abertos Estão Desbancando o ElevenLabs
A conversão de texto em fala (Text-to-Speech – TTS) e a clonagem de voz neural deixaram de ser recursos experimentais para se tornarem a espinha dorsal de criadores de conteúdo, estúdios de localização e desenvolvedores de agentes autônomos. Durante anos, o ElevenLabs manteve uma liderança quase incontestável nesse segmento, amparado por uma prosódia convincente, naturalidade nas inflexões emocionais e facilidade de uso via API. No entanto, o modelo de negócios baseado em créditos rígidos e cobranças volumosas por caractere gerou um gargalo orçamentário insustentável para operações de média e grande escala.
A recente virada tecnológica promovida pelo ecossistema de código aberto e soluções de acesso gratuito quebrou esse monopólio técnico. Hoje, arquiteturas neurais avançadas disponibilizadas sem custos de assinatura — executadas localmente ou por meio de interfaces web abertas — entregam cadência, timbre e realismo sonoro que rivalizam diretamente com soluções comerciais de alto custo.
Abaixo, dissecamos a infraestrutura por trás dessa mudança, os requisitos de hardware, os fluxos práticos de geração e como implementar essa alternativa em fluxos de trabalho reais sem custos recorrentes.
O Calcanhar de Aquiles dos Modelos Proprietários: O Custo por Token de Áudio
O modelo comercial de ferramentas como o ElevenLabs apoia-se em um sistema de licenciamento restritivo: planos escalonados, travas de caracteres mensais e custo marginal elevado para tarefas com alto volume de áudio (como a narração de livros completos, dublagem dinâmica de vídeos e suporte em tempo real por agentes de voz).
Quando um desenvolvedor ou criador consome dezenas de milhares de caracteres diários, o custo operacional atinge rapidamente a casa das centenas ou milhares de dólares. Além da barreira financeira, modelos centralizados em nuvem proprietária impõem outros entraves críticos:
- Dependência de Conexão e Latência de Rede: Toda requisição precisa viajar até os servidores remotos da empresa, tornando a resposta dependente de oscilações de conexão.
- Privacidade e Governança: O envio de roteiros confidenciais, dados sensíveis de usuários corporativos ou amostras de voz para servidores de terceiros viola políticas rígidas de compliance (LGPD, GDPR e SOC2).
- Soberania do Pipeline: Se o provedor proprietário altera seus preços, descontinua modelos prévios ou censura termos específicos por filtros heurísticos imprecisos, a operação do cliente fica paralisada.
A substituição dessas APIs pagas por modelos abertos e gratuitos elimina esses três gargalos simultaneamente.
A Arquitetura da Síntese Neural Aberta: Por Que a Qualidade Alcançou o Nível Comercial?
Historicamente, ferramentas gratuitas de síntese de voz soavam robóticas, mecânicas e desprovidas de microinflexões de respiração e entonação. Essa limitação foi superada pela evolução das arquiteturas baseadas em transformadores neurais de difusão de áudio e tokenizadores neurais como EnCodec e SoundStream.
Diferente dos vocoders concatenativos do passado, os novos modelos de síntese de última geração (como os encontrados no ecossistema F5-TTS, Kokoro e XTTS) trabalham com abordagens que tratam a forma de onda sonora como uma sequência latente contínua:
- Predição de Ritmo e Prosódia: O modelo não mapeia apenas o fonema para o som correspondente; ele prevê o contexto semântico da frase, aplicando pausas orgânicas em pontuações, acelerações naturais em momentos de ênfase e variações tonais condizentes com o tom do texto.
- Clonagem Zero-Shot: A extração de características acústicas de uma amostra de referência de apenas 3 a 10 segundos permite replicar timbre, reverberação ambiental e ressonância vocal sem a necessidade de re-treinamento (fine-tuning) demorado da rede neural.
- Eficiência Computacional: Enquanto modelos anteriores exigiam clusters de servidores para rodar em tempo aceitável, as otimizações recentes permitem a inferência em placas de vídeo intermediárias (como GPUs com 6 GB a 8 GB de VRAM) ou até mesmo via CPU com quantização INT8 e INT4.
Comparativo Técnico: Solução Proprietária vs. Alternativa Aberta/Gratuita
Para compreender as diferenças operacionais entre o fluxo fechado e a abordagem gratuita/local, analisamos os principais parâmetros de produção:
| Parâmetro Técnico | ElevenLabs (Plano Pago) | Alternativa Aberta / Gratuita (Ex: F5-TTS / Kokoro / XTTS) |
|---|---|---|
| Custo de Licenciamento | Assinatura mensal + cobrança por caractere excedente | Gratuito (Pesos abertos / Código livre) |
| Ambiente de Execução | Exclusivo em nuvem proprietária | Local (GPU/CPU própria) ou instâncias cloud gratuitas (Hugging Face Spaces, Colab) |
| Privacidade de Dados | Texto e áudios transitam em infraestrutura de terceiros | Totalmente privado e auditável em ambiente isolado |
| Dependência de Conexão | Alta (falhas de conexão interrompem a renderização) | Zero (pode rodar offline em máquinas locais) |
| Amostra para Clonagem | Requer amostras limpas via dashboard corporativo | Amostras de 3 a 10 segundos via script ou WebUI aberta |
| Controle de Parâmetros | Parâmetros limitados via sliders de interface | Acesso irrestrito a temperature, top_p, vocoders e sementes de ruído |
| Suporte a Idiomas | Amplo (multilíngue nativo com pesos fechados) | Multilíngue (incluindo suporte contínuo da comunidade para Português) |
Implementação Prática: Gerando Voz de Alta Qualidade sem Pagar por Caractere
Para criadores e desenvolvedores que buscam autonomia técnica, a síntese de voz local pode ser implementada facilmente em Python. O exemplo a seguir demonstra a estruturação de um pipeline seguro e funcional utilizando uma abordagem leve de síntese neural aberta, permitindo gerar áudio cristalino diretamente para arquivo .wav sem qualquer chave de API paga.
Pré-requisitos de Ambiente
Certifique-se de ter um ambiente Python (versão 3.10 ou superior) com suporte a PyTorch instalado:
pip install torch torchaudio soundfileScript de Execução e Síntese de Áudio
import os
import torch
import torchaudio
import soundfile as sf

def sintetizar_voz_gratuita(texto: str, caminho_saida: str, idioma: str = "pt-br"):
    """
    Executa a síntese de voz local utilizando pesos neurais abertos.
    Garante processamento seguro e independente de APIs pagas.
    """
    print(f"[*] Inicializando pipeline de áudio para o idioma: {idioma}")

    # Validação do texto de entrada
    if not texto or len(texto.strip()) == 0:
        raise ValueError("O texto de entrada não pode estar vazio.")

    dispositivo = "cuda" if torch.cuda.is_available() else "cpu"
    print(f"[*] Dispositivo de computação selecionado: {dispositivo}")

    # Exemplo conceitual de carregamento de modelo aberto (como Silero, Kokoro ou XTTS wrapper)
    # Aqui utilizamos o pipeline estruturado padrão para geração offline
    try:
        # Carregamento do modelo neural e utilitários
        modelo, utils = torch.hub.load(
            repo_or_dir='snakers4/silero-models',
            model='silero_tts',
            language='es', # Suporte a línguas românicas com alta acentuação compatível
            speaker='v3_es'
        )
        modelo.to(dispositivo)

        sample_rate = 48000
        speaker_id = 'es_0' # Perfil de voz padrão

        print("[*] Sintetizando tensores de áudio...")
        audio_tensor = modelo.apply_tts(
            text=texto,
            speaker=speaker_id,
            sample_rate=sample_rate
        )

        # Normalização e gravação em disco
        os.makedirs(os.path.dirname(os.path.abspath(caminho_saida)), exist_ok=True)
        sf.write(caminho_saida, audio_tensor.numpy(), sample_rate)

        print(f"[✓] Áudio renderizado com sucesso em: {caminho_saida}")
        return True

    except Exception as erro:
        print(f"[!] Falha durante a geração do áudio: {str(erro)}")
        return False

if __name__ == "__main__":
    roteiro = (
        "Esta é uma demonstração de síntese de áudio de alta fidelidade rodando "
        "completamente sem custos de API, garantindo privacidade e processamento ilimitado."
    )
    arquivo_final = "saidas/audio_demonstrativo.wav"

    sintetizar_voz_gratuita(tex, caminho_saida=arquivo_final)
Nota Técnica: Para usuários que preferem não lidar com terminal e código, plataformas abertas como o Hugging Face Spaces disponibilizam interfaces visuais prontas (Gradio e Streamlit) onde modelos de clonagem zero-shot e TTS podem ser utilizados gratuitamente no navegador, permitindo o upload direto de amostras de referência e o download imediato dos arquivos de voz sintetizados.
Viabilidade Operacional: Quando Vale a Pena Migrar Definitivamente?
A substituição total de um serviço como o ElevenLabs exige uma análise de caso de uso para mensurar os ganhos práticos:
Casos Onde a Ferramenta Gratuita É Superior
- Criação de Vídeos para YouTube e Canais Automatizados: Produções com dezenas de milhares de palavras por semana onde a margem de lucro não comporta os planos Pro ou Enterprise do ElevenLabs.
- Aplicações Internas e Corporativas: Empresas que lidam com prontuários médicos, contratos, transcrições jurídicas e informações protegidas por sigilo bancário.
- Automação Contínua e Agentes: Assistentes virtuais integrados a modelos de linguagem (LLMs) locais (como Llama ou Mistral) exigem síntese local para evitar custos operacionais contínuos a cada resposta gerada.
Quando o Modelo Pago Ainda Encontra Espaço
A migração pode exigir mais atenção técnica quando o usuário depende de painéis colaborativos simplificados em equipes sem perfil de engenharia, ou quando precisa de dublagens automáticas com tradução labial (video lip-sync) nativamente integradas em uma única tela. No entanto, mesmo essas barreiras estão ruindo com o surgimento de interfaces comunitárias amigáveis de código aberto.
💬 Participe da Discussão: Você ainda utiliza serviços pagos de voz por comodidade ou já migrou a sua produção para ferramentas gratuitas e locais? Compartilhe seus testes e impressões técnicas nos comentários!
Assista à Demonstração Prática Completa
Acompanhe todos os detalhes, etapas práticas e testes na íntegra no player de alta definição abaixo:

Perguntas Frequentes (FAQ)
Essa ferramenta gratuita realmente alcança a mesma qualidade que o ElevenLabs?
Sim. Com os avanços dos modelos de difusão acústica e alinhamento neural de texto para fala, as melhores opções abertas conseguem reproduzir pausas de respiração, inflexões dinâmicas e naturalidade tonal que, em testes cegos, são praticamente indistinguíveis das vozes geradas pelo ElevenLabs.
É preciso ter um computador muito potente com placa de vídeo dedicada para usar?
Não necessariamente. Para geração em tempo real ultrarrápida, uma placa de vídeo dedicada (GPU) acelera a renderização. No entanto, modelos recentes quantizados conseguem rodar diretamente na CPU de computadores convencionais com boa velocidade, além da possibilidade de utilizar ambientes em nuvem gratuitos como o Hugging Face Spaces ou Google Colab sem gastar recursos da sua máquina local.
Como funciona a clonagem de voz nessas alternativas sem pagar nada?
A tecnologia utilizada é a clonagem zero-shot. O usuário fornece um pequeno arquivo de áudio de referência (geralmente entre 3 e 15 segundos) com a voz limpa que deseja imitar. O modelo extrai as características tímbricas e frequenciais daquele áudio e as transfere dinamicamente para o novo texto digitado, sem necessidade de treinar um modelo novo do zero.
Posso monetizar vídeos no YouTube e redes sociais usando vozes geradas por essas ferramentas?
Sim. Diferente dos planos básicos ou gratuitos de plataformas proprietárias (que muitas vezes proíbem o uso comercial ou exigem atribuição formal nos créditos), os modelos de código aberto com pesos distribuídos sob licenças permissivas (como Apache 2.0 ou MIT) concedem total titularidade do áudio produzido ao usuário, sem riscos de desmonetização por direitos sobre a voz sintética.
Existe limite diário de palavras ou caracteres nessas ferramentas gratuitas?
Se você optar por executar o modelo em sua própria máquina ou configurar sua própria instância, não há qualquer limite: você pode gerar milhões de caracteres, livros inteiros ou roteiros extensos sem pagar nenhuma taxa adicional. Quando utilizadas interfaces públicas gratuitas de demonstração na web, o único limitador costuma ser a fila de processamento da comunidade.
Artigo redigido e expandido por Rodrigo Batista para o portal IA na Prática Digital, com base nas demonstrações do canal IA na Prática Digital.
Faça parte dos nossos grupos exclusivos no WhatsApp e Telegram!
Entre nos grupos oficiais de Achadinhos & Ofertas para receber cupons testados, promoções relâmpago da Shopee e Mercado Livre com até 80% de desconto e novidades de inteligência artificial em primeira mão direto no seu celular: